Planification de la bande passante PCIe : quel débit net pouvez-vous vraiment tirer de Gen3 x4 à x16 ?
La facture de bande passante PCIe est bien plus complexe que le chiffre sur la fiche technique — débit brut, surcharge de codage, surcharge protocolaire, efficacité DMA et goulot DDR grignotent chacun ce « 16 Go/s ». Cet article déroule Gen3 x4/x8/x16, jusqu’au matching DDR et DMA, et donne une méthode réutilisable pour estimer la bande passante nette.
1. Trois couches de bande passante : brute, encodée, nette
Quand vous voyez « PCIe Gen3 x16 » sur une fiche technique, votre intuition dit 16 Go/s. Ce chiffre est en fait le débit binaire brut, pas la bande passante utilisable dans votre système. Deux couches de perte s’intercalent :
| Couche | Calcul Gen3 x16 | Résultat | Signification |
|---|---|---|---|
| ① Débit binaire brut | 16 voies × 8,0 GT/s | 128 Gb/s | Débits de symboles brut sur le lien |
| ② Bande passante post-codage | 128 × 128/130 (Gen3 utilise 128b/130b) | ≈ 126 Gb/s ≈ 15,75 Go/s | Débits de données utiles après surcharge de codage |
| ③ Bande passante nette réelle | 15,75 × efficacité de transfert (80 %–90 %) | ≈ 12,6 – 14,2 Go/s | Bande passante réellement utilisable après entêtes TLP, descripteurs DMA, interrupts |
Gen3 tourne à 8,0 GT/s par voie avec seulement 1,5 % de surcharge de codage 128b/130b — c’est pourquoi Gen3 est bien plus efficace que Gen2 (qui porte 20 % de surcharge 8b/10b). Comparaison largeurs :
| Largeur PCIe | Débit binaire brut | Bande passante post-codage | Bande passante nette typique (DMA gros blocs) |
|---|---|---|---|
| Gen3 x4 | 32 Gb/s | ≈ 3,94 Go/s | ≈ 3,2 – 3,5 Go/s |
| Gen3 x8 | 64 Gb/s | ≈ 7,88 Go/s | ≈ 6,3 – 7,1 Go/s |
| Gen3 x16 | 128 Gb/s | ≈ 15,75 Go/s | ≈ 12,6 – 14,2 Go/s |
| Gen2 x8 (référence) | 40 Gb/s | ≈ 4,0 Go/s (8b/10b) | ≈ 3,2 – 3,6 Go/s |
2. Combien de surcharge protocolaire : TLP, payload, lecture vs écriture
La bande passante post-codage n’est pas la bande passante nette. Chaque paquet de couche transaction PCIe (TLP) porte un entête de 12–20 octets ; plus le payload est gros, plus la part d’entête est petite, et plus l’efficacité est élevée.
La taille de payload détermine directement l’efficacité
| Taille de payload | Part d’entête TLP | Efficacité de transfert | Scénario typique |
|---|---|---|---|
| 4 Ko (max) | ≈ 0,4 % | ≈ 90 %+ | Acquisition DMA continue gros blocs, flux vidéo |
| 512 o | ≈ 3 % | ≈ 85–88 % | Retour de données général |
| 64 o | ≈ 25 % | 55–65 % | Lectures/écritures de registres, contrôle petits paquets |
Les lectures sont plus lentes que les écritures : le coût caché des Completion
Les écritures PCIe sont fire-and-forget ; l’émetteur n’attend pas d’acquittement. Les lectures PCIe doivent attendre le retour d’un TLP Completion — un aller-retour qui double la latence et coûte de la bande passante. Mesuré :
- Écritures séquentielles gros blocs : 88–92 % de la bande passante post-codage
- Lectures séquentielles gros blocs : typiquement seulement 80–85 % (file d’attente Completion, surcharge)
- Lecture/écriture mixte : changement de direction cause des stalls de lien, faisant chuter l’efficacité de 5–10 % supplémentaires
En planification ingénierie, utilisez l’estimation conservative « bande passante nette = post-codage × 80 % », pas le chiffre idéal 90 %+, pour laisser de la marge.
3. La DDR est le vrai plafond
Un lien PCIe rapide ne signifie pas que le système tourne à pleine vitesse — les données entrent et sortent du FPGA par la DDR, et la bande passante DDR est souvent le premier mur que vous heurtez.
Comment calculer la bande passante DDR
Bande passante DDR = largeur bus données × débit / 8. Pour les cartes courantes de Duyuan :
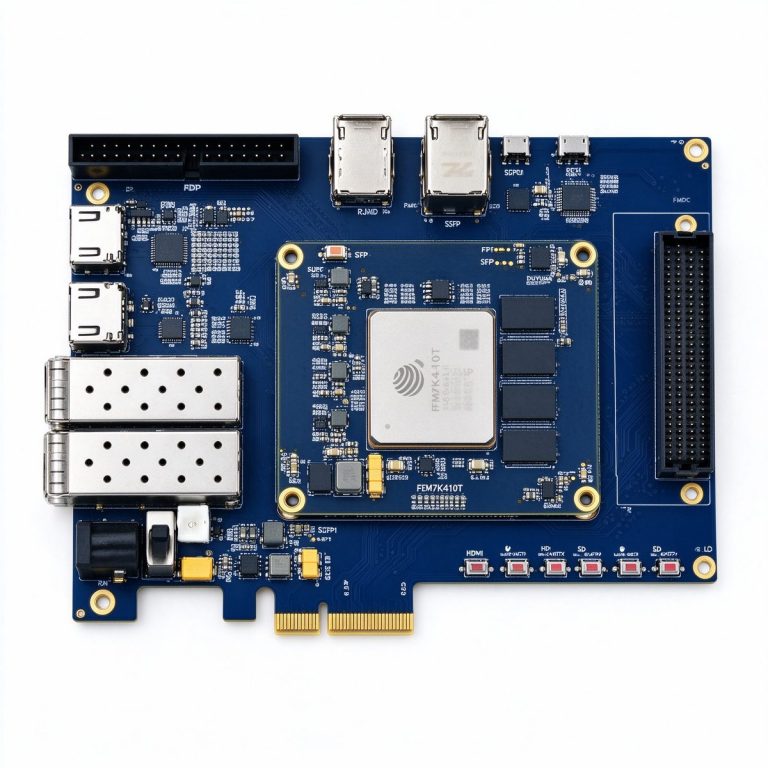
- DUK7410T : 4 Go DDR3, bus 64 bits, 1866 Mbps → 64 × 1866 / 8 ≈ 14,9 Go/s
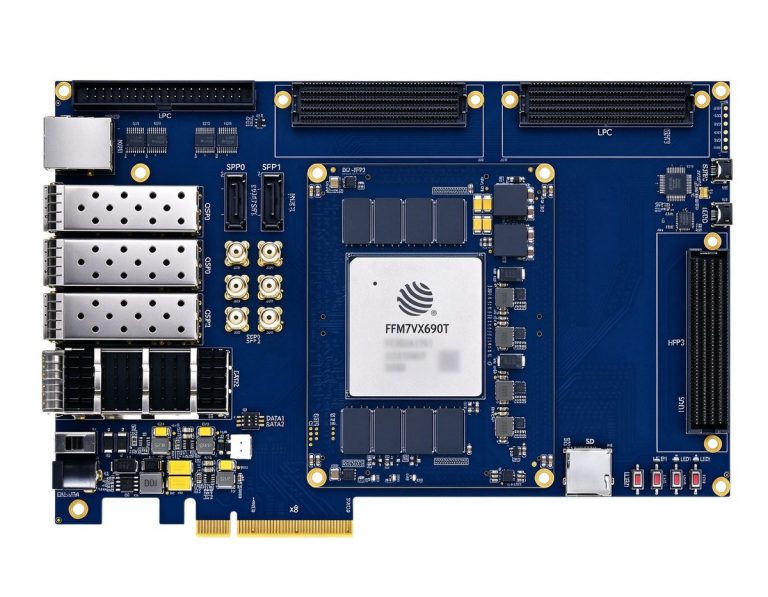
- DUF7690T : 4 Go DDR3, 64 bits, 1866 Mbps → ≈ 14,9 Go/s
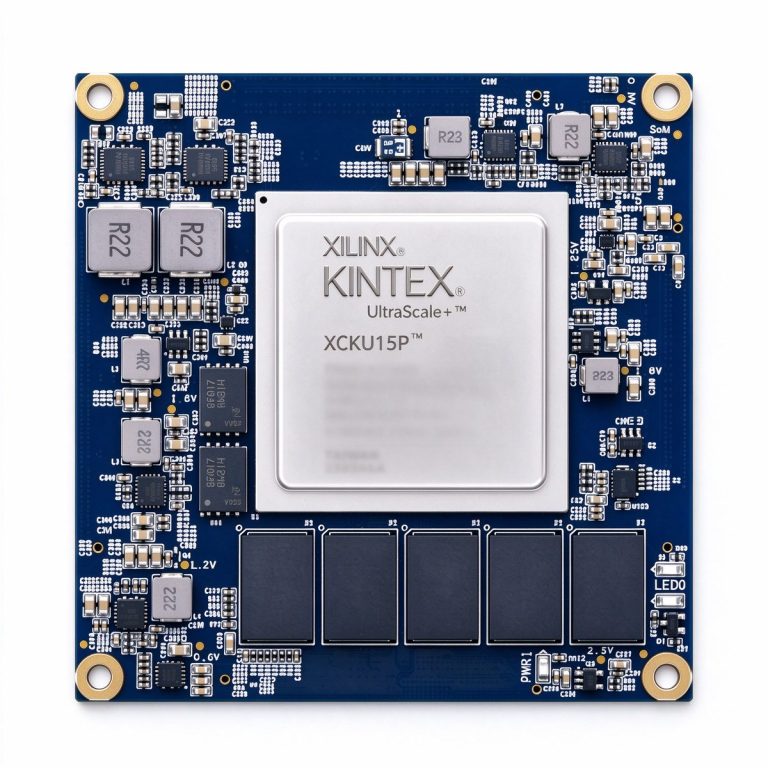
- DUKU15P : 8 Go DDR4 ECC, bus 64 bits (+8 bits ECC) → à 2400 MT/s ≈ 19,2 Go/s
Le flux de données est bidirectionnel : lecture + écriture doublent la charge
Prenons un scénario d’acquisition haute vitesse : les données ADC sont traitées par le FPGA et réécrites vers l’hôte sur PCIe. Ce chemin de données traverse la DDR deux fois :
- FPGA reçoit les données → écriture DDR (frame buffer)
- FPGA finit le traitement → lecture DDR (récupération pour transmission)
- Charge DDR totale = bande passante écriture + bande passante lecture
Si la bande passante nette PCIe x8 Gen3 est de 7 Go/s, la DDR doit simultanément écrire 7 Go/s et lire 7 Go/s = 14 Go/s — approchant la limite physique DDR3 de 14,9 Go/s, ne laissant presque rien pour le travail algorithme FPGA. C’est pourquoi x8 Gen3 associé à DDR3 est la « combinaison dorée », tandis que x16 nécessite DDR4.
| Carte | Spéc PCIe | Bande passante post-codage | Config DDR | Bande passante DDR | Verdict matching |
|---|---|---|---|---|---|
| DUK7410T | Gen2 x8 | ≈ 4,0 Go/s | 4 Go DDR3 64 bits | ≈ 14,9 Go/s | PCIe est le goulot, DDR a de la marge |
| DUF7690T | Gen3 x8 | ≈ 7,88 Go/s | 4 Go DDR3 64 bits | ≈ 14,9 Go/s | ~7,5 Go/s dans chaque sens, juste équilibré |
| DUKU15P | Gen3 x16 | ≈ 15,75 Go/s | 8 Go DDR4 64 bits | ≈ 19,2 Go/s | DDR approche sa limite à charge PCIe pleine |
4. Estimation en trois étapes : de quelle bande passante votre projet a-t-il besoin ?
Méthodologie · 01 : estimation de la bande passante PCIe en trois étapes
Étape 1 : calculer la demande nette. Additionnez les débits de données brutes de toutes les sources — le volume minimum qui doit être déplacé.
Étape 2 : appliquer un facteur de redondance. Multipliez par 1,2–1,5 pour la surcharge, les bursts et le duplex.
Étape 3 : rétro-calculer la largeur PCIe. Choisissez une spécification où la bande passante post-codage ≥ demande redondante, puis vérifiez que la DDR suit.
Validé sur trois scénarios courants :
| Scénario | Débit brut | Demande post-redondance | PCIe recommandé | Pourquoi |
|---|---|---|---|---|
| Acquisition haute vitesse (2ch × 250 MSPS × 14 bits) | ≈ 875 Mo/s | ≈ 1,1 – 1,3 Go/s | Gen3 x4 (3,94 Go/s) | Marge ample, DDR sans stress |
| Capture et traitement vidéo 4K60 (10 bits 4:2:2) | ≈ 1,5 Go/s | ≈ 1,8 – 2,3 Go/s | Gen3 x8 (7,88 Go/s) | Place pour vidéo multi-canal ou multiplexage |
| Retour massif feature-map inférence IA / vidéo 8K | ≈ 10 – 12 Go/s | ≈ 12 – 18 Go/s | Gen3 x16 (15,75 Go/s) | Nécessite DDR4, sinon DDR heurte le mur en premier |
Règle de base : en choisissant la largeur PCIe, rétro-calculer depuis la demande nette × 2, et laisser un facteur deux complet de marge. Vous pouvez upgrader la bande passante, mais vous ne pouvez pas upgrader la largeur sans redesign de carte.
5. Choisir parmi les trois plateformes PCIe de Duyuan
DUK7410T (9 999 ¥) — acquisition et traitement sensibles au coût
Fudan Micro JFM7K410T, IP dur PCIe Gen2 x8, ~4 Go/s post-codage. À associer aux modules FMC HPC pour acquisition ADC haute vitesse, ou traitement vidéo HDMI 4K — commencez ici quand la bande passante PCIe n’est pas le goulot.
DUF7690T (24 999 ¥) — acquisition mainstream et traitement composite
Fudan Micro JFM7VX690T, IP dur PCIe Gen3 x8, ~7,88 Go/s post-codage. Avec 4 Go DDR3 à ~7,5 Go/s dans chaque sens, il matche la bande passante pleine x8. Plateforme mainstream pour acquisition multi-canal, traitement de signal radar et multiplexage vidéo.
DUKU15P (15 999 ¥) — retour de données haut de gamme et interconnexion 100G
AMD Kintex UltraScale+ XCKU15P, IP dur PCIe Gen3 x16, 15,75 Go/s post-codage, associé à 8 Go DDR4 ECC. Intègre 56 transceivers haute vitesse (24× GTY 28G + 32× GTH 16G) et 4× IP dur Ethernet 100G — choix flagship pour retour PCIe grande bande passante plus réseau haute vitesse.
La bande passante PCIe n’est jamais juste « vitesse d’interface » — c’est la planche la plus courte de « interface × mémoire × DMA ». Planifiez d’abord la marge DDR, puis parlez de la vitesse PCIe.
— Équipe R&D Duyuan