Contrôle visuel industriel temps réel sur FPGA : des caméras GigE à l’étalonnage des défauts
Le long d’une chaîne d’inspection de défauts sur ligne de production, du pixel caméra au signal de rejet, où le FPGA est-il irremplaçable ? Cet article calcule d’abord le budget de bande passante du flux de données complet, puis détaille les quatre rôles que joue le FPGA dans la chaîne visuelle, compare les limites temps réel des algorithmes traditionnels vs deep learning, et termine par un choix matériel déployable à travers un cas réel de station AOI à joints brasés sur PCB.
1. D’abord, la facture de bande passante : flux de données sur une ligne 1080p60
La première difficulté en vision industrielle n’est pas l’algorithme, c’est la bande passante. Prenons le chemin le plus ordinaire — une seule caméra GigE Vision 1080p, 60 i/s — et calculons son débit de données :
| Format de sortie | Calcul | Résultat | Peut-elle passer sur un lien Gigabit ? |
|---|---|---|---|
| Bayer 8 bits (le plus courant) | 1920 × 1080 × 8 bit × 60 | ≈ 995 Mb/s ≈ 124 Mo/s | Sature 99,5 % du 1 Gb/s, à peine |
| Bayer 12 bits (HDR / basse lumière) | 1920 × 1080 × 12 bit × 60 | ≈ 1,49 Gb/s ≈ 187 Mo/s | Dépasse le Gigabit ; nécessite 2,5G/10G ou CoaXPress |
| 4 caméras 8 bits | 995 Mb/s × 4 | ≈ 4 Gb/s ≈ 500 Mo/s | Nécessite agrégation 4× Gigabit ou uplink 10G |
Si vous transmettez ces trames brutes entières vers un CPU ou un GPU, chaque canal pousse 124–187 Mo par seconde ; quatre canaux signifient 500 Mo/s. Côté CPU, il faut encore traiter une trame complète — on brûle bande passante et calcul aux deux bouts. Ce que la détection de défauts demande réellement, c’est seulement « où est l’anomalie, quel type, quelles coordonnées » — souvent juste quelques centaines d’octets.
La clé : l’endroit où les pixels sont traités décide du coût de toute la chaîne
Déplacer les trames brutes ailleurs pour les traiter, c’est la mentalité « déménageur » ; traiter les pixels sur place au fil de l’eau, c’est la mentalité « pipeline ». La première ajoute un canal complet de bande passante et de calcul par caméra supplémentaire ; la seconde n’ajoute que la logique de traitement.
2. Les quatre rôles du FPGA dans la chaîne visuelle
Rôle 1 : mise en route interface et synchronisation multi-caméras
Le parsing des protocoles GigE Vision / CoaXPress, la configuration des paramètres caméra et la gestion des triggers sont pris en charge directement par la couche MAC du FPGA et la logique de déclenchement. Plusieurs caméras se verrouillent sur la même horloge de trigger matériel, garantissant que les trames de différents points de vue sont exposées au même instant — ce que le logiciel peine à égaler de façon déterministe.
Rôle 2 : prétraitement d’image (débruitage, gain, interpolation Bayer)
Débruitage, balance des blancs, gain, interpolation Bayer, extraction de ROI — autant d’opérations par pixel. Le pipeline FPGA avance naturellement d’un pixel par cycle d’horloge ; l’horloge pixel du 1080p60 est autour de 148,5 MHz, largement dans la marge de temporisation de circuits comme le JFM7K410T. Le même travail par pixel sur CPU est une boucle de plusieurs à dizaines de millisecondes par trame ; sur FPGA, c’est une latence fixe de quelques dizaines de cycles d’horloge.
Rôle 3 : détection de défauts (template, différence, composantes connexes)
Appariement de templates, différence de trames, seuillage, analyse de composantes connexes, traitements morphologiques — tout est parallélisable, tout est en pipeline. L’appariement de templates sur une image 1080p sur FPGA s’exécute en moins de 1 ms par trame, avec une latence indépendante de la fréquence d’images et totalement déterministe — une exigence dure pour le temps de cycle ligne.
Rôle 4 : sortie de résultat et coordination des IO
Le verdict pilote directement l’actuateur de rejet, la lampe d’alarme et les compteurs statistiques. La latence de sortie GPIO du FPGA est de l’ordre du nanoseconde, sans détour par l’OS, le driver ou la couche applicative. Dès qu’un défaut apparaît, le signal de rejet a déjà atteint l’actuateur.
3. Deux chemins algorithmiques : vision traditionnelle vs deep learning
« Il suffit d’ajouter du deep learning » est devenu un mantra sur les projets de vision ces dernières années, mais la frontière temps réel entre les deux chemins doit être tracée clairement :
| Dimension | Vision traditionnelle (template/différence/morphologie) | Deep learning (CNN/YOLO) |
|---|---|---|
| Latence trame simple 1080p | < 1 ms (pipeline FPGA) | 2–10 ms (GPU) ou plus (NPU général) |
| Empreinte ressources | Petit compte de LUT/DSP | DSP lourd + bande passante mémoire externe |
| Interprétabilité | Seuils ajustables, défauts traçables | Boîte noire, difficile de localiser les faux positifs |
| Meilleur cas | Défauts à motifs fixes, lignes à cycle rapide | Défauts complexes, re-vérification hors ligne d’échantillons variés |
| Implémenté sur FPGA | Mûr, hautement ingénié | Nécessite quantification/élagage ; généralement sur CPU/GPU |
L’architecture ligne mainstream 2026 est prétraitement FPGA + verdict temps réel traditionnel + re-vérification deep learning hors ligne : le FPGA garantit le verdict et le rejet dans le temps de cycle, tandis que le deep learning effectue une confirmation secondaire sur les zones suspectes — chacun faisant ce qu’il fait de mieux.
4. Un cas réel : station AOI à joints brasés sur PCB
Cas d’ingénierie · 01 : inspection de joints brasés sur ligne SMT — 60 i/s en continu, taux de faux appels < 0,5 %
Une station AOI sur ligne SMT doit détecter les joints froids, les ponts de soudure et les composants manquants, fonctionner en continu à 60 i/s, avec un objectif de faux appels sous 0,5 % et un taux de manquement sur joint froid sous 1 %.
- Caméras : 2 × caméras industrielles GigE 20 MP, recadrées en ROI 1080p, sortie Bayer 8 bits
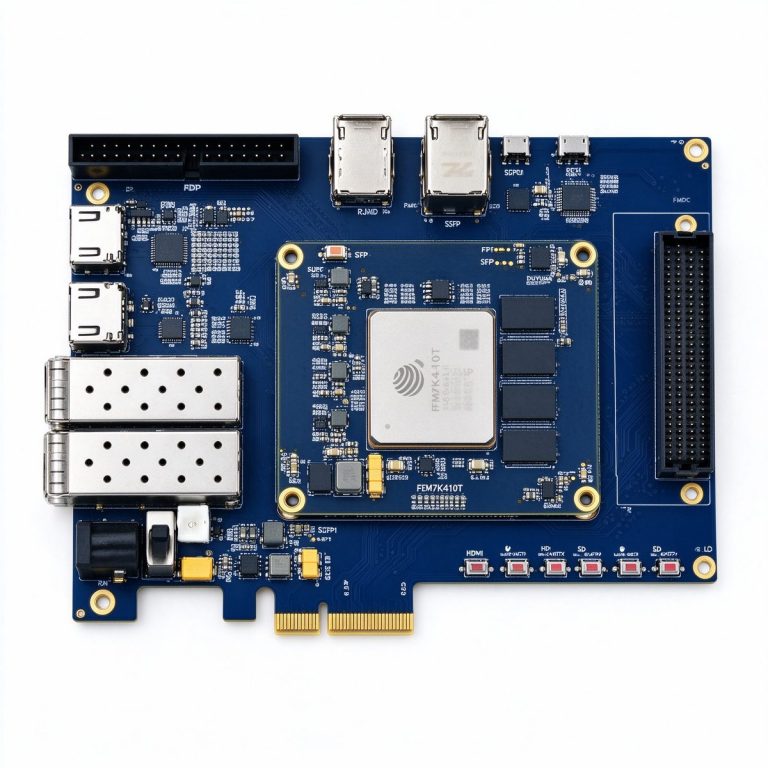
- Carte : DUK7410T (Fudan Micro JFM7K410T, 406K cellules logiques, FMC HPC, 4 Go DDR3)
- Flux de données : 2 × 995 Mb/s ≈ 2,5 Gb/s entrée FPGA → frame buffer DDR → différence de template + analyse de composantes connexes → sortie de verdict
Résultats mesurés : traitement trame simple < 0,8 ms ; latence de bout en bout du trigger caméra à la sortie de rejet < 1,5 ms ; taux de faux appels < 0,5 % ; taux de détection des joints froids > 99 %.
Vs baseline CPU : latence de bout en bout réduite de ~15 ms à < 1,5 ms, charge CPU hôte de 85 % à 5 % — le pipeline logiciel initial n’atteignait que 30 i/s ; le passage au FPGA a doublé le débit.
La clé de cette station n’est pas un algorithme sophistiqué — c’est que l’action d’inspection suit le temps de cycle de la ligne. Dès qu’une trame de défaut arrive, le verdict et le rejet doivent être terminés avant la trame suivante.
5. Comment choisir le matériel : trois cartes, trois stratégies
Le choix suit trois questions : combien de caméras ? quelle exigence de latence ? quel budget machine total ? Voici les trois plateformes courantes de Duyuan :
DUK7410T (9 999 ¥) — la bête de somme moyenne, choix standard pour AOI 1/2 caméras
Fudan Micro JFM7K410T, 406K cellules logiques, 1 540 DSP, FMC HPC, entrée HDMI 4K, 2× SFP+. Le FMC HPC se connecte directement aux modules FMC de caméra haute vitesse ou d’ADC ; l’entrée HDMI 4K peut faire office de bouclage d’affichage. Positionnement vision, détection de défauts, prototypes de multiplexage vidéo — la plupart des projets commencent ici.
PBC7K325G (1 999 ¥) — intégration machine embarquée sensible au coût
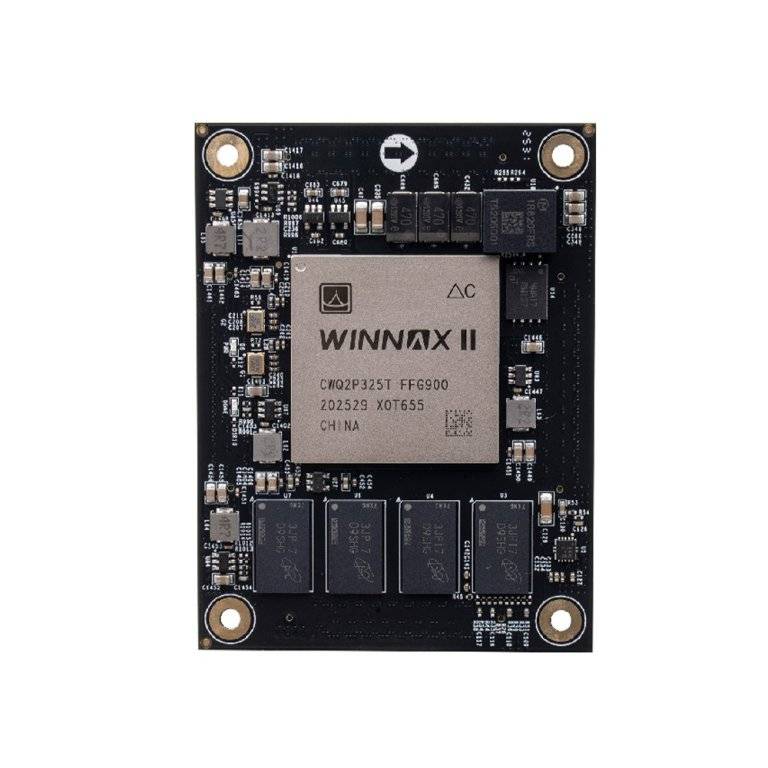
SoM architecture Kintex-7 chinois, 326K cellules logiques, 16 transceivers GTX, 2 Go DDR3, grade industriel −40 à 85 °C. Inspection embarquée à motif fixe mono-caméra, ou contrôleurs vision + motion control combinés. Les produits sensibles au coût sortent d’ici.
DUF7690T (24 999 ¥) — réseaux multi-caméras et systèmes composites haute performance
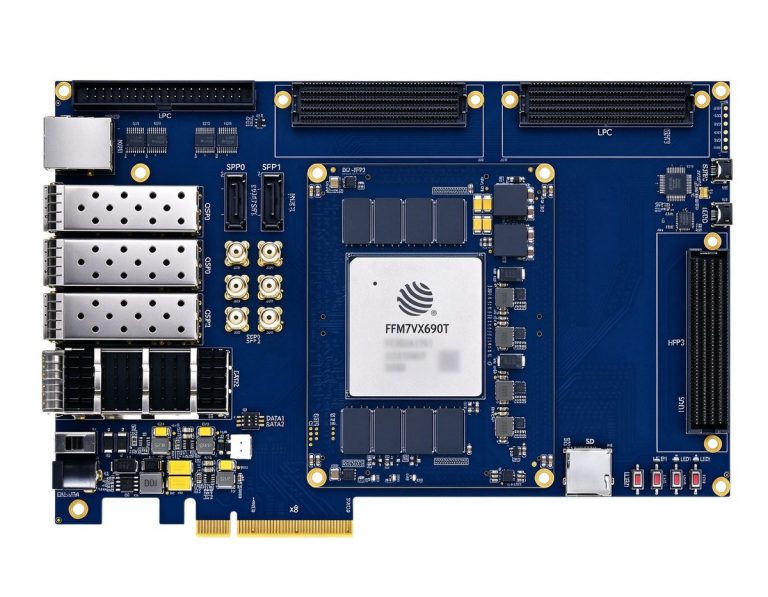
Fudan Micro JFM7VX690T, 693K cellules logiques, 3 600 DSP, 36 paires GTH, QSFP 40G. Réseaux 8+ caméras, multiplexage 8K, ou systèmes composites vision + communication fibre — quand vous avez besoin de grande logique et de grande bande passante, passez à cette carte.
Le premier principe de la vision industrielle est « ne pas faire circuler des trames entières » — traitez les pixels là où ils transitent, et les problèmes de latence, bande passante et puissance disparaissent aussitôt.
— Équipe R&D Duyuan