Faisceau ultrasonore médical : chaîne de signal 128 canaux et budget de débit
Une sonde ultrasonore couleur 128 canaux échantillonne chaque canal avec un ADC 12 bits, 40 MS/s, donnant un débit de données brutes d’environ 7,7 Go/s — un niveau qu’un CPU ne peut absorber, et encore moins imager en temps réel. La bonne approche est de faire tourner d’abord le faisceau, la détection d’enveloppe et le sous-échantillonnage à l’intérieur du FPGA, et seulement passer les données imagées compressées à l’hôte. Cet article découpe la chaîne 128 canaux en étapes, budgète le débit à chaque étape, et explique exactement ce que fait le FPGA entre deux.
1. La chaîne complète de signal d’imagerie ultrasonore
De la matrice de la sonde à l’image en niveaux de gris à l’écran, le signal parcourt une longue chaîne, avec le FPGA positionné après le frontend analogique et avant l’imagerie hôte :
- Matrice de sonde (128 éléments) : émet des ultrasons et reçoit les échos des tissus ; chaque élément correspond à un canal indépendant.
- Frontend analogique (AFE) : compensation de gain temps (TGC) → filtre passe-bande → amplification à gain variable → numérisation ADC.
- Faisceau FPGA : retard programmable par canal, pondération et sommation en une ligne de balayage, complétant la focalisation dynamique.
- Démodulation IQ + sous-échantillonnage + détection d’enveloppe : compresser le signal RF haute fréquence en données d’amplitude en niveaux de gris.
- Conversion de balayage + frame buffer + upload PCIe : convertir les lignes de balayage polaires en cartésiennes, et envoyer à l’hôte pour DSC et cartographie couleur.
La raison pour laquelle les étapes 3 et 4 doivent tourner sur le FPGA est simple : 128 canaux doivent être alignés, retardés et pondérés-sommé en microsecondes, avec chaque retard changeant dynamiquement avec la profondeur. C’est un travail hautement parallélisé, par canal, à temporisation déterministe ; le logiciel sur un CPU généraliste manque à la fois de parallélisme et de fréquence d’images temps réel.
2. Budget de débit 128 canaux (calculez avant de connecter)
Le budget commence depuis l’ADC mono-canal et se multiplie vers le haut. Prenons un ADC 12 bits, 40 MS/s :
| Étape | Débit par canal | Total 128 canaux | Note |
|---|---|---|---|
| Échantillonnage brut ADC | 12 bit × 40 MS/s = 480 Mb/s (60 Mo/s) | 128 × 480 = 61440 Mb/s ≈ 61,4 Gb/s (7,68 Go/s) | Pic brut entrant dans le FPGA |
| Faisceau (somme retardée) | 128 canaux pondérés-sommés → 1 ligne de balayage | Plus 128 chemins parallèles après sommation | Le parallélisme est compressé ici |
| Démodulation IQ + sous-échantillonnage CIC/FIR | RF 40 MS/s → ~10 MS/s équivalent complexe | Chemin simple ~20 Mo/s (12 bits complexe) | Sous 1/4 du brut après décimation |
| Détection d’enveloppe + compression log | Amplitude 8 bits, ~10 MS/s | Chemin simple ~10 Mo/s | Plage dynamique compressée à 40–60 dB |
| Upload PCIe vers hôte | — | 256 lignes × 60 i/s × 8 bit ≈ 122 Mo/s | Le CPU gère seulement ce niveau |
Conclusion clé : la compression se fait à l’intérieur du FPGA. Ce qui entre dans le FPGA est un flux parallèle brut de 61,4 Gb/s ; ce qui sort vers l’hôte n’est qu’environ 122 Mo/s de données de trame en niveaux de gris. Le ratio de compression dépasse 60×, atteint par le faisceau fusionnant 128 chemins en un seul, puis le sous-échantillonnage et la détection écrasant le RF haute fréquence en une enveloppe d’amplitude. Sautez le FPGA et poussez le flux brut de 7,68 Go/s vers un CPU, et ni la bande passante mémoire ni PCIe ne peuvent le gérer.
Fréquence d’images vs nombre de lignes de balayage
Dans le faisceau, chaque ligne de balayage nécessite une nouvelle somme retardée 128 canaux. Laissons une trame contenir N lignes à la fréquence d’images F ; le FPGA doit compléter N×F sommes par seconde. Avec N=256 et F=60 i/s, cela fait 256 × 60 = 15360 lignes de balayage par seconde, chacune sommant 128 échantillons pondérés et retardés — le point de départ pour dimensionner les multiplieurs FPGA (DSP) et la RAM sur puce (FIFO de ligne de retard).
3. Comment la chaîne interne du FPGA est divisée
1. Acquisition synchronisée et alignement de canaux
Les 128 canaux s’étendent généralement sur plusieurs AFE entrant dans le FPGA via JESD204B ou LVDS parallèle. La première porte est la compensation de skew : les longueurs de trace diffèrent par canal, donc les échantillons doivent s’aligner sur une référence d’horloge unique avant le FIFO ; sinon la sommation retardée a un défaut de phase, produisant des lobes latéraux et des artefacts fantômes.
2. Sommation retardée à focalisation dynamique
Chaque élément est à une distance différente du point de focalisation, donc les échos arrivent à des moments différents. Le FPGA compense cette différence de temps par canal avec des lignes de retard programmables (FIFO réglables en profondeur ou retards à pointage), puis multiplie par un poids d’apodisation et somme. La profondeur de focalisation se déplace avec la porte temporelle, donc les paramètres de retard se rafraîchissent par segment ; cela consomme beaucoup de BRAM sur puce et DSP pour le multiply-accumulate.
3. Démodulation IQ, sous-échantillonnage et détection d’enveloppe
La ligne RF sommée passe d’abord par une démodulation en quadrature (mélange I/Q), puis une cascade CIC + FIR décime la fréquence d’échantillonnage ; une transformée de Hilbert trouve l’enveloppe, et la compression log mappe la grande plage dynamique vers les niveaux de gris 8 bits. Cette étape est un filtrage de pipeline typique — haute utilisation DSP mais faible parallélisme.
4. Conversion de balayage, frame buffer et upload
Les lignes de balayage polaires en éventail sont ré-échantillonnées en pixels rectangulaires cartésiens, écrites dans un frame buffer DDR3/4, puis le DMA envoie la trame entière via PCIe vers l’hôte. Cette étape se soucie de la bande passante lecture/écriture DDR et du moteur DMA, pas du débit DSP.
4. Cas d’ingénierie : dimensionnement du frontend ultrasonore couleur portable
Un frontend ultrasonore couleur portable utilise un AFE 128 canaux échantillonnant le RF à 40 MS/s, 12 bits. Le faisceau doit traiter 128 lignes de retard et multiplieurs pondérés en parallèle, plus un canal Doppler flux sanguin. Selon le budget ci-dessus, les 61,4 Gb/s bruts se compressent à l’intérieur du FPGA en environ 122 Mo/s de trames en niveaux de gris ; une bande passante nette PCIe Gen2 x4 la porte confortablement.
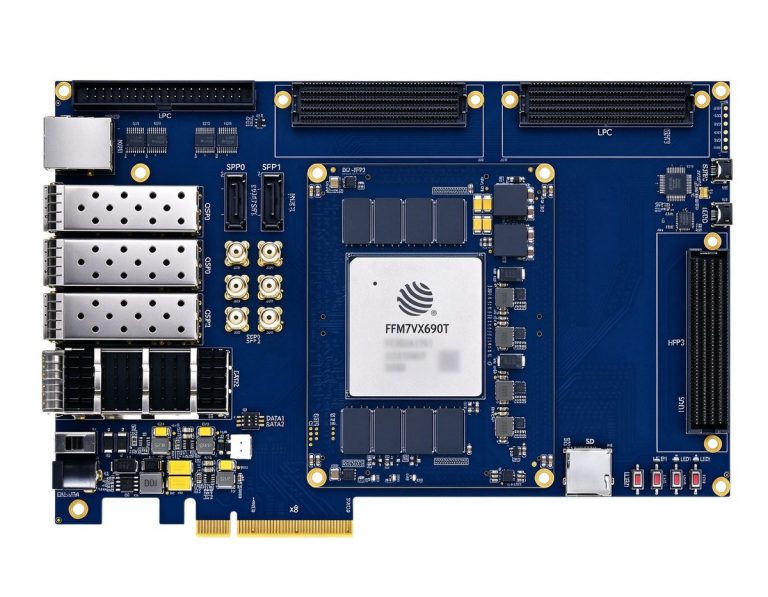
- Haute capacité (DUF7690T / JFM7VX690T) : logique et RAM sur puce amplement suffisantes pour contenir 128 FIFO de ligne de retard, synthèse niveaux de gris et canal Doppler en même temps ; adapté à un design complet 128 canaux, haute fréquence d’images.
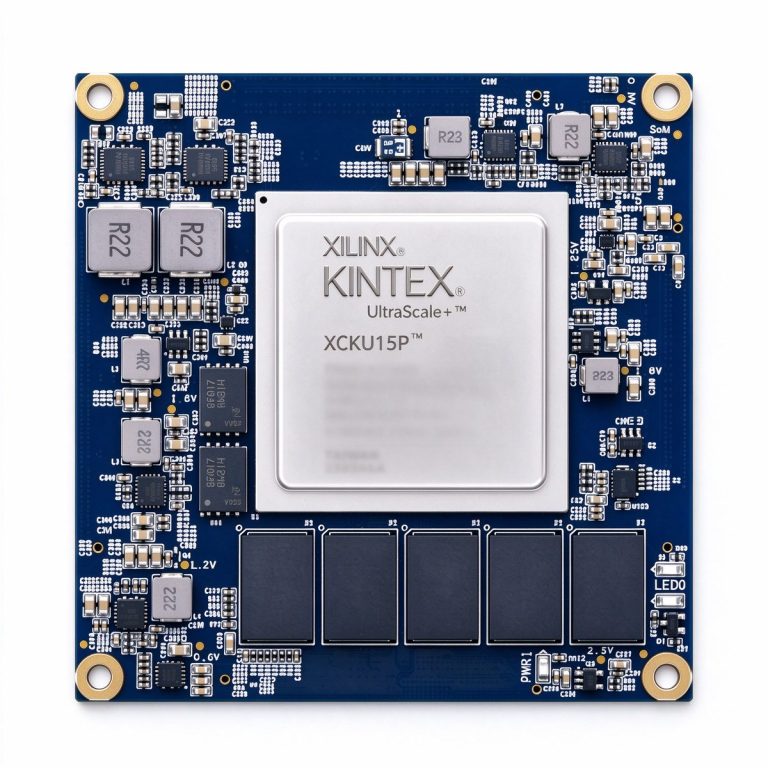
- Expansion haute canal (XCKU15P) : transceivers forts et agrégation LVDS multi-canal ; adapté à une expansion de canaux plus poussée ou à des sondes distribuées qui renvoient les données AFE sur fibre.
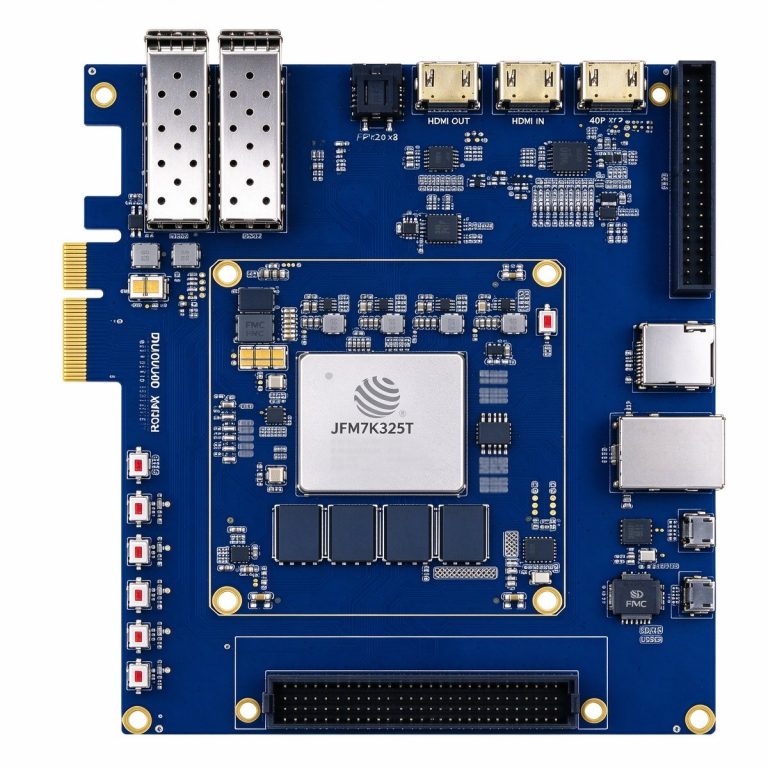
- Entrée de gamme moyenne (DUK7325T / JFM7K325T) : ressources et coût équilibrés ; adapté au prototype niveaux de gris 64–128 canaux et aux produits entrée/moyenne gamme — faites tourner la chaîne sommation retardée et détection ici avant de passer à une plateforme haute capacité.
L’imagerie ultrasonore est, à son cœur, l’utilisation de la sommation retardée parallèle à l’intérieur du FPGA pour transformer 128 échos bruts haute vitesse en une seule ligne de balayage. Une fois le budget de débit clair — 61,4 Gb/s frontend, 122 Mo/s upload — vous savez quelle étape doit rester sur puce et laquelle peut aller à l’hôte. En ultrason médical, le FPGA n’est pas une carte d’accélération ; c’est l’imagerie elle-même.