Backhaul fibre 10G/25G : planification du débit de ligne GTX/GTH et offload UDP
Quand plusieurs ADC haute vitesse, faisceaux radar ou flux vidéo convergent, le cuivre plafonne après quelques mètres et le PCIe ne peut quitter le châssis. Le bon backhaul est de piloter SFP+/QSFP directement depuis les transceivers GTX/GTH du FPGA, d’offloader la MAC et la pile IP/UDP sur puce, et d’envoyer seulement le payload sur fibre au débit de ligne. Cet article calcule le débit de ligne 10G/25G, le payload UDP, le budget de lien et la division interne du FPGA.
1. Pourquoi les données haute vitesse ont besoin d’un backhaul fibre
À l’intérieur de la carte vous utilisez PCIe, et les courts liens carte-à-carte utilisent le cuivre, mais une fois que les nœuds d’acquisition sont distribués, la distance dépasse quelques mètres et chaque canal tourne à plusieurs Gb/s ou plus, le cuivre et le backplane heurtent leur plafond en premier :
- Plafond de distance : un câble DAC à 10G supporte généralement seulement 3–5 m, et le cuivre actif est limité aussi ; la fibre monomode avec un module optique atteint facilement 10 km, adapté aux réseaux d’acquisition distribués et aux fronts radar distants.
- Plafond de bande passante : un seul 1080p60, IF SDR multi-canal, ou IQ radar fusionné dépasse souvent 10 Gb/s ; le cuivre gigabit et les backplanes ne peuvent pas le porter, donc vous avez besoin de SFP+ (10G) ou QSFP28 (25G/100G).
- Immunisation timing et bruit : dans les environnements industriels bruyants, la fibre fournit une isolation électrique, une immunisation contre la diaphonie et les boucles de masse, et un timing commun plus stable entre les nœuds.
Le pattern typique : une carte d’acquisition distante ne fait que l’échantillonnage ADC et le prétraitement, emballe les résultats et les envoie sur une fibre vers un serveur central, qui ne traite pas les canaux individuellement mais reçoit seulement le flux agrégé. Ici le débit de ligne du lien et la surcharge protocolaire décident directement combien de nœuds peuvent être attachés.
2. Débit de ligne 10G/25G et budget payload UDP (calculez le payload d’abord)
Beaucoup traitent un « port 10 Gb/s » comme bande passante utilisable, mais ce qui arrive à la couche application est le payload après encodage, gap inter-trame et entêtes de protocole. Commencez depuis comment le débit de ligne apparaît :
| Poste | 10G (SFP+) | 25G (QSFP28) | Note |
|---|---|---|---|
| Débit Ethernet nominal | 10,0 Gb/s | 25,0 Gb/s | Débit MAC effectif |
| Débit de ligne encodé 64b/66b | 10 × 66/64 = 10,3125 Gb/s | 25 × 66/64 = 25,78125 Gb/s | Débit binaire réel sur le fil |
| Surcharge trame MTU 1500 | Preamble/SFD 8B + gap 12B + Eth 14B + IP 20B + UDP 8B | Identique | ~62B non-payload par trame |
| Ratio payload UDP | 1500/(1500+62) = 96,03 % | ≈ 96,03 % | Exclut la retransmission couche application |
| Débit payload UDP (MTU1500) | 10 × 96,03 % ≈ 9,60 Gb/s | 25 × 96,03 % ≈ 24,0 Gb/s | Ce que la couche application reçoit réellement |
| Ratio Jumbo Frame (9000B) | 9000/9062 = 99,32 % | 99,32 % | Élève le payload à ~9,93 / ~24,8 Gb/s |
Conclusion clé : sur UDP MTU1500, un port 10G délivre seulement environ 9,6 Gb/s à l’app, pas 10 Gb/s. Dimensionnez les nœuds sur le payload : si chaque nœud envoie 2 Gb/s de données effectives, un lien 10G tient environ 4–5 nœuds (9,6 / 2, avec marge), pas un 5 complet. Pour approcher le débit de ligne, activez Jumbo Frame pour amortir la surcharge fixe par trame.
BER et budget de lien
Un lien fibre n’est pas terminé une fois branché ; calculez d’abord le budget de puissance optique : puissance d’émission − sensibilité du récepteur = marge de lien, dont vous déduisez l’atténuation fibre (monomode 1310 nm ≈ 0,35 dB/km) et la perte de soudure/connecteur (~0,5 dB par connecteur). SR multimode 850 nm est limité par la distance et OM3/OM4 ; LR monomode 1310 nm atteint 10 km. Un lien conforme cible un BER meilleur que 1e-12 ; le 25G ajoute couramment la correction d’erreur avant transmission RS-FEC, corrigeant les erreurs brutes ~1e-5 à 1e-15, donc incluez le gain de codage FEC dans le budget.
3. Comment le FPGA divise le travail
1. Les transceivers GTX/GTH pilotent le module optique
Le Series-7 GTX plafonne à 10,3125 Gb/s, matchant SFP+ 10G ; les GTH/GTY UltraScale/UltraScale+ tournent au-dessus de 16G et supportent 25G. Le transceiver gère la sérialisation/désérialisation, l’encodage 8b/10b ou 64b/66b et la récupération d’horloge ; extérieurement ne restent que les paires haute vitesse et la gestion I2C du module (lecture DDM).
2. MAC et traitement de trame
Au-dessus du transceiver se trouve la MAC Ethernet 10G/25G : délimitation de trame, vérification CRC, flux de contrôle PAUSE. Rx drop les trames CRC-bad et filtre par MAC destination ; Tx encapsule les trames et remplit les gaps. Cette couche est un pipeline déterministe adapté au matériel complet.
3. Moteur d’offload UDP
Laisser le CPU paqueter IP/UDP par trame devient un goulot à 10G. Offload sur puce : le matériel remplit IP source/destination, ports et checksum ; l’utilisateur écrit seulement le payload dans le buffer DMA, et le moteur ajoute les entêtes Eth/IP/UDP, calcule le checksum et fragmente par MTU. Le CPU ne paquete pas, configure seulement la table d’adresse une fois à l’init — c’est l’offload de pile protocolaire.
4. Statistiques d’erreurs et surveillance de lien
Les compteurs sur puce totalisent les erreurs CRC, les trames droppées et les corrections FEC, rapportés périodiquement via le canal de gestion ; le DDM du module de puissance Tx, puissance optique Rx et température sont aussi collectés, alertant tôt quand la marge chute au lieu d’attendre une image cassée.
4. Cas d’ingénierie : acquisition multi-nœuds backhaulée sur fibre 10G
Un système d’acquisition distribué a 4 nœuds distants ; chacun fusionne deux canaux IF SDR et un canal vidéo pour ~2,2 Gb/s effectifs de backhaul ; le centre agrège sur une fibre 10G, et avec Jumbo Frame le payload est ~9,9 Gb/s, donc 4 nœuds totalisant 8,8 Gb/s laissent de la marge. Tous les protocoles sont offloadés en UDP dans le FPGA ; l’hôte reçoit seulement le payload.
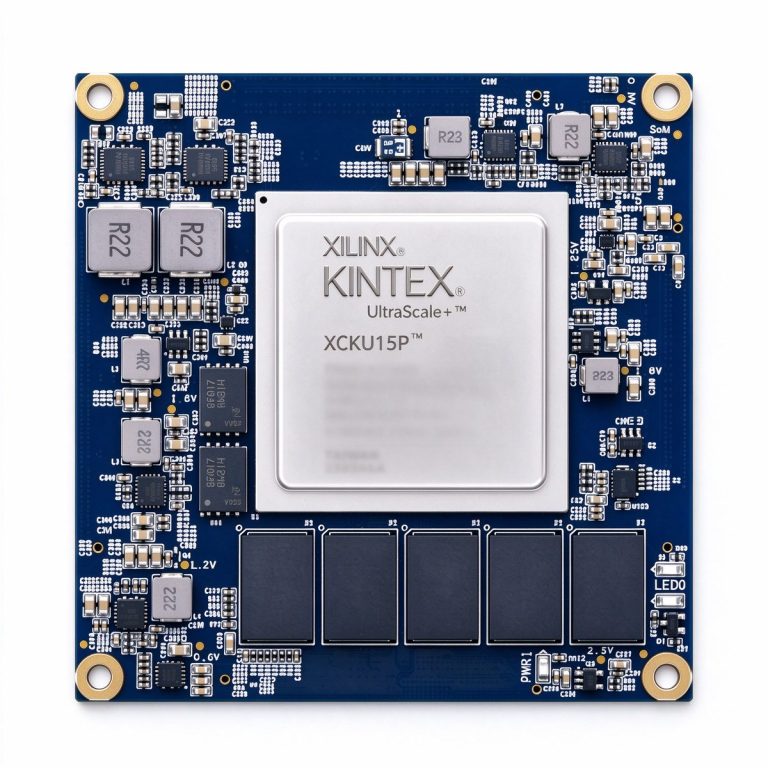
- Lien haute bande passante (XCKU15P / Kintex UltraScale+) : marge GTY transceiver généreuse pour 25G ou plusieurs voies 10G, adapté à un nœud d’agrégation principal qui peut passer à 25G/100G.
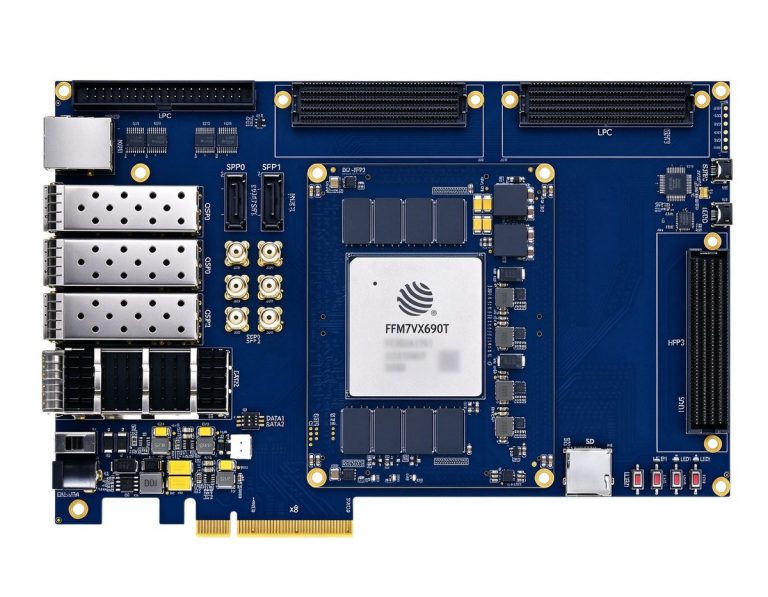
- Agrégation haute capacité (DUF7690T / JFM7VX690T) : logique et RAM sur puce amplement suffisantes pour plusieurs MAC, moteurs d’offload UDP et grandes files, adapté à l’agrégation centrale multi-nœuds et au forwarding au débit de ligne.
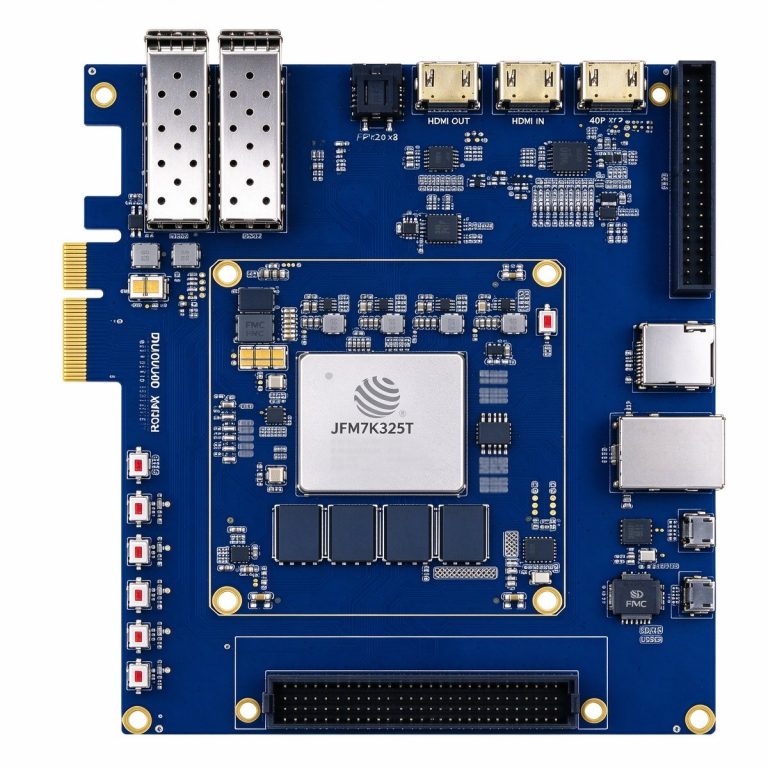
- Entrée de gamme prototype 10G (DUK7325T / JFM7K325T) : le Series-7 GTX sature le débit de ligne 10G à coût équilibré, adapté au prototype 10G mono-nœud et aux produits entrée de gamme.
Le backhaul fibre est essentiellement laisser les transceivers du FPGA et la pile matérielle terminer « envoyer au débit de ligne » au nom du CPU. Gardez deux chiffres : sur MTU1500, 10G délivre ~9,6 Gb/s et 25G ~24 Gb/s de payload. Dimensionnez les nœuds sur le payload plutôt que le débit nominal, calculez le budget de lien et le BER en amont, et le backhaul ne perdra pas de vitesse sur le terrain.