Réseaux multi-caméras embarqués : comment FPGA/MPSoC fait tourner l’inférence IA temps réel à la périphérie
Quand quatre caméras sur une ligne renvoient toutes vers un serveur central pour la détection, la bande passante ne suit pas et la latence ne peut pas être compressée. Le meilleur chemin est de faire la capture, le prétraitement et l’inférence sur la carte elle-même, ne renvoyant que les résultats de détection et un aperçu compressé. Cet article divise l’architecture embarquée IA périphérique en rôles PS/PL, avec le budget de bande passante et le chemin de déploiement du modèle.
1. Pourquoi pousser l’inférence IA sur la carte
L’approche centralisée historique sur les lignes multi-caméras : chaque caméra alimente un switch, les flux bruts retournent vers un serveur central, et un GPU serveur fait la détection sur tout. Avec peu de caméras cela marche, mais à plus de canaux deux problèmes apparaissent : la bande passante brute non compressée est énorme, et l’inférence centralisée ajoute une latence aller-retour réseau et de file d’attente inévitable.
D’abord le calcul de la bande passante brute : un seul flux brut 1080p30, YUV422 (2 octets par pixel) = 1920×1080×2×30 ≈ 124 Mo/s ≈ 995 Mb/s ; quatre canaux empilés font environ 4 Gb/s de flux non compressé, avant le décodage côté serveur, la mise en file d’attente et la surcharge d’encodage. À cette échelle le coût du lien et la latence de bout en bout d’une architecture centralisée sont difficiles à faire descendre.
Le schéma embarqué inverse cela : la carte fait le prétraitement et l’inférence localement, et n’envoie que les résultats structurés (cadre englobant, classe, confiance, quelques Ko par trame) plus un aperçu compressé ; les pixels bruts ne quittent jamais la carte.
2. Architecture IA embarquée : ce que PS et PL gèrent chacun
Le Zynq UltraScale+ MPSoC place un processeur d’application quad-core A53 (PS) et une logique programmable (PL) dans une puce, accordant « ordonnancement plus système » avec « chemins de données parallèles ».
1. PL : pipeline de capture et prétraitement
Les signaux caméra (MIPI CSI, USB ou GigE) entrent dans le PL, où le parallélisme matériel fait d’abord tourner le débruitage, le scaling, la conversion colorimétrique et la normalisation de format. Ces opérations sont naturellement par pixel et parallèles ; un pipeline PL les fait bien plus vite qu’un CPU série et laisse l’A53 libre.
2. PL : inférence parallèle sur modèles quantifiés
La convolution, le pooling et l’activation tournent dans le PL en un tableau parallèle de slices DSP : les poids sont dans la Block RAM/UltraRAM sur puce ou la DDR4 côté PL, et les feature maps d’entrée transitent par le tableau multiply-accumulate. Après quantification INT8 la taille du modèle et le trafic mémoire chutent fortement. Le PL ne fait tourner aucun OS ; son pipeline déterministe tient un beat fixe par trame.
3. PS : ordonnancement, Linux et rapport de résultats
Le PS quad-core A53 fait tourner Linux pour l’ordonnancement de tâches, la communication hôte et l’emballage des résultats ; l’encodeur VCU intégré comprime simultanément une trame d’aperçu en H.264/H.265 et l’envoie sur le réseau seulement quand une personne a besoin de la voir.
3. Budget de bande passante : pourquoi le flux multi-caméras brut ne peut pas retourner
| Étape de lien | 1080p30 simple | Quatre canaux | Note |
|---|---|---|---|
| Brut non compressé (YUV422) | ~995 Mb/s | ~4,0 Gb/s | Approche historique de retour complet vers serveur |
| Résultat structuré après prétraitement | quelques Ko/trame | quelques Ko/trame | cadre + classe + confiance |
| Aperçu compressé (H.264) | 2–4 Mb/s | 8–16 Mb/s | Envoyé seulement quand vu |
Le traitement embarqué coupe la bande passante sortante de Gb/s à Mb/s voire Kb/s ; le serveur central reçoit seulement les résultats et ne réserve plus de décodage et d’inférence par caméra. Cette frontière « pixels bruts restent sur la carte, seuls les résultats sortent » est le cœur de l’avantage périphérique sur un schéma centralisé.
4. Déploiement du modèle et choix de carte
1. Quantifier et élaguer d’abord
Quantifiez le modèle en INT8 sur la carte, élaguez et coupez les poids pour réduire le volume ; puis divisez les pipelines de couches par le stockage sur puce et la capacité DSP pour que toute la table de poids n’entre pas d’un coup dans la puce. Un flux style Vitis-AI compile, quantifie et déploie le modèle vers les unités d’accélération PL, tandis que le PS Linux héberge encore l’application.
2. Choisissez une carte par nombre de canaux et calcul
Rôles des cartes vision périphérique : prototype entrée de gamme / calcul multi-canal / parallélisme pure-FPGA
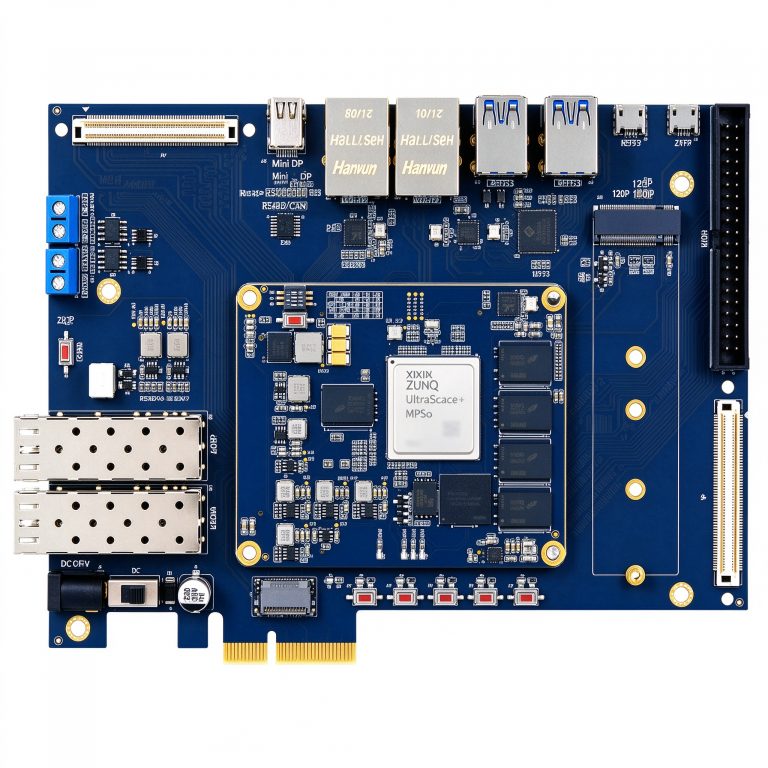
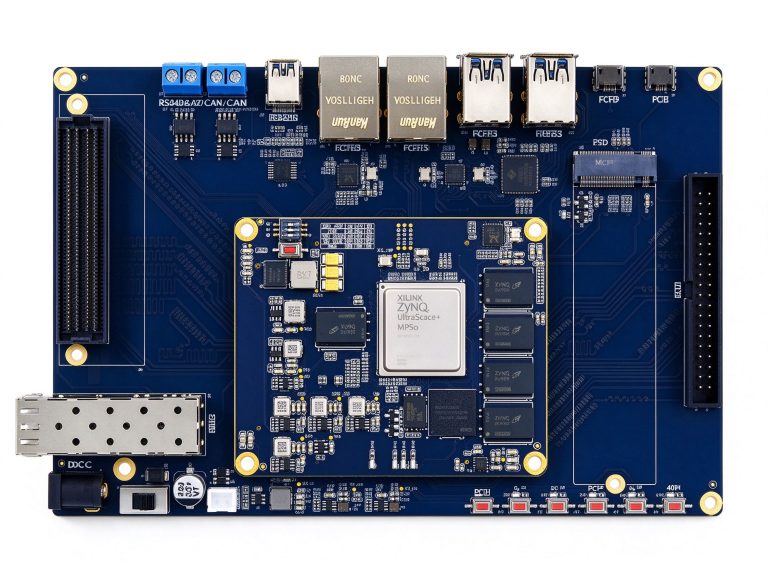
- Prototype périphérique entrée de gamme (DUUZ4EV, RFQ) : XCZU4EV, 192K cellules logiques, 728 DSP, VCU intégré, PS 4 Go + PL 4 Go DDR4 ; pour prototypes IA périphériques une à deux caméras et validation PYNQ rapide.
- Calcul multi-canal élevé (DUUZ5EV, RFQ) : XCZU5EV, 256K cellules logiques, 1 248 DSP, 16 paires GTH, expansion FMC-LPC ; la plateforme pour plus de canaux et des modèles plus lourds.
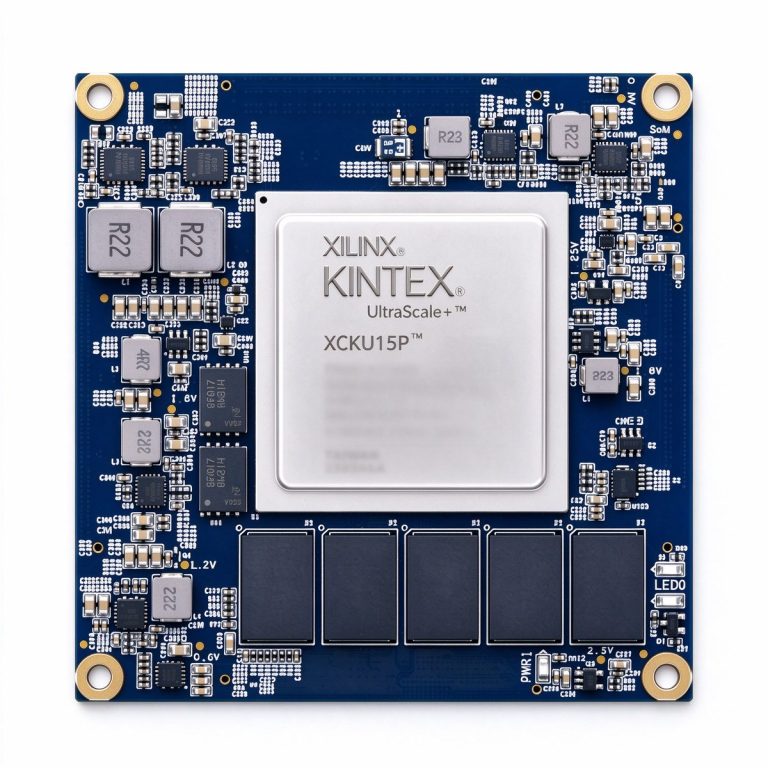
- Expansion parallèle pure-FPGA (XCKU15P, 15 999 ¥) : carte cœur Kintex UltraScale+ pour traitement parallèle de flux multi-caméras et agrégation haute vitesse où un système PS n’est pas nécessaire.
L’inférence IA périphérique n’est pas rétrécir le GPU serveur ; cela signifie découper toute la chaîne « capture–prétraitement–inférence–rapport » sur la carte : le PL porte le traitement parallèle de pixels et la convolution quantifiée, le PS porte l’ordonnancement et la communication, et le VCU comprime l’aperçu en cours de route. Les pixels bruts restent sur la carte et seuls les résultats sortent — bande passante et latence se relâchent toutes les deux.