VU13P en trading quantitatif : une plate-forme matérielle basse latence du décodage des données marché à l’exécution des ordres
L’essence du trading quantitatif est de compléter la boucle d’information « arrivée des données marché → calcul de signal → transmission des ordres » dans le temps le plus court possible. Cet article utilise la plate-forme AMD Virtex UltraScale+ XCVU13P (VU13P) comme fil conducteur, expliquant pourquoi elle convient au trading quantitatif et comment la déployer en une chaîne de trading basse latence livrable.
L’essence du trading quantitatif est de compléter la boucle d’information « arrivée des données marché — calcul de signal — transmission des ordres » dans le temps le plus court possible. À l’échelle microseconde du moteur d’appariement d’une bourse, la latence elle-même est un coût : être une microseconde en retard signifie un slippage de prix, des opportunités perdues, ou l’échec d’une stratégie entière. Au cours de la dernière décennie, les sociétés de trading propriétaire leaders ont progressivement migré les parties les plus critiques de la chaîne du logiciel CPU vers le matériel FPGA — décodage des données marché sur carte, carnet d’ordres sur carte, décisions de stratégie sur carte, et génération d’ordres sur carte. Cet article utilise la plate-forme AMD Virtex UltraScale+ XCVU13P (VU13P) comme fil conducteur, discutant pourquoi elle convient au trading quantitatif et comment la déployer en une chaîne de trading basse latence livrable.
1. La structure de latence du trading quantitatif : pourquoi la réponse est le FPGA
Une chaîne de trading automatisée typique — d’un paquet de données marché arrivant au NIC à un ordre quittant le NIC — passe séquentiellement par la pile réseau, le parsing des données marché, la maintenance du carnet d’ordres, le calcul de signal, les contrôles de risque et l’encodage des ordres. Dans une pile logicielle, les interruptions du noyau, le traitement de la pile protocole, l’ordonnancement des threads et les cache misses introduisent tous une gigue incontrôlable ; l’implémentation matérielle transforme ces étapes en une profondeur de pipeline fixe avec latence déterministe, pas d’interruptions, pas d’ordonnancement. Latence tick-to-trade de bout en bout approximative pour différentes approches d’implémentation :
| Implémentation | Latence de bout en bout typique |
|---|---|
| Logiciel ordinaire + pile réseau noyau | 10–100 µs |
| Logiciel kernel-bypass (DPDK / Onload + core pinning) | 1–5 µs |
| Chaîne FPGA complète (parsing → stratégie → ordre) | 300 ns – 1 µs |
| Trigger pré-armé FPGA (pattern match et envoi) | 30–100 ns |
| Switch layer-1 (pur fan-out / réplication) | environ 5 ns |
Trois propriétés du FPGA déterminent ce gap d’ordre de grandeur : parallélisme — multiples feeds de données marché et instances de stratégie tournent simultanément en matériel sans contention ; déterministe — pas d’interruptions ou d’ordonnancement, la latence de traitement de chaque paquet est fixe, ce qui compte également pour le contrôle de risque et l’audit ; proximité — les ports optiques se connectent directement au FPGA, contournant PCIe et la pile protocole, décodant les paquets à leur arrivée. Les données publiques de l’industrie confirment cela : certaines solutions annoncent une latence tick-to-trade aller-retour sub-100 ns, le design de référence AMD avec des partenaires pour CME atteint une latence de trigger pré-armé au niveau 25 ns ; un article 2025 dans *Computer Applications and Software* décrivant un système d’accélération de données marché ultra-basse latence basé sur OpenCL a atteint 678 ns de traitement minimal de données marché sur un Alveo U50 avec 38,4 Gbit/s de débit, environ 12× d’amélioration de performance par rapport à l’approche logicielle.
2. Vue d’ensemble des capacités de la plate-forme VU13P
VU13P appartient à la famille AMD Virtex UltraScale+ et est un dispositif représentatif au point d’équilibre « échelle logique × interface haute vitesse ». Selon la documentation produit officielle AMD, ses spécifications clés sont :
| Métrique | Spécification XCVU13P |
|---|---|
| Cellules logiques système | 3 780K (environ 3,78 millions de cellules logiques) |
| DSP Slices | 12 288 |
| Transceivers haute vitesse GTY | 128 paires (jusqu’à 32,75 Gb/s par paire) |
| IO utilisateur | 832 |
| Interfaces haute vitesse intégrées | PCIe Gen3 x16, MAC Ethernet 100G, Interlaken 150G (blocs durs in-die) |
| Calcul DSP | jusqu’à environ 38 TOP/s |
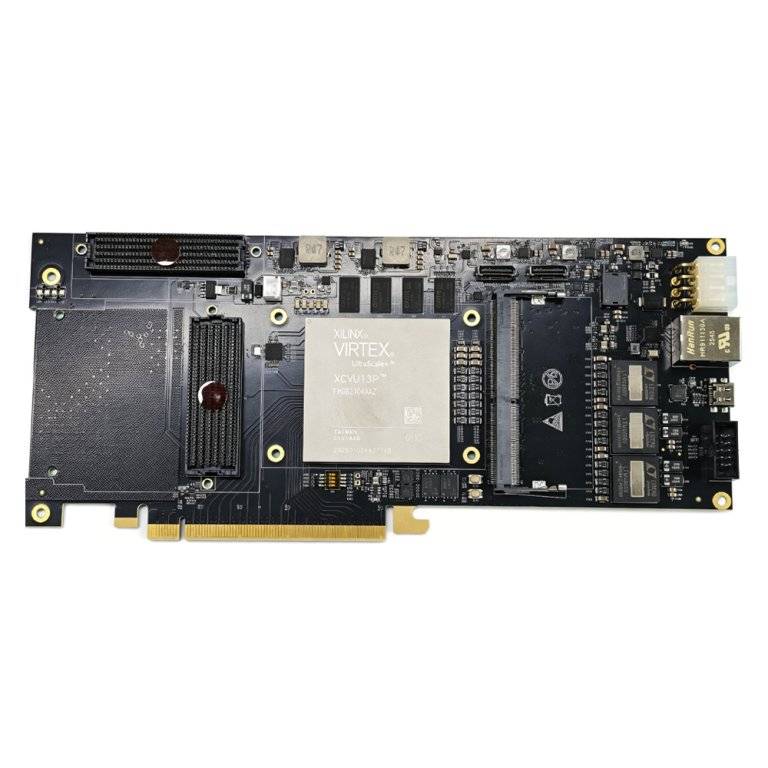
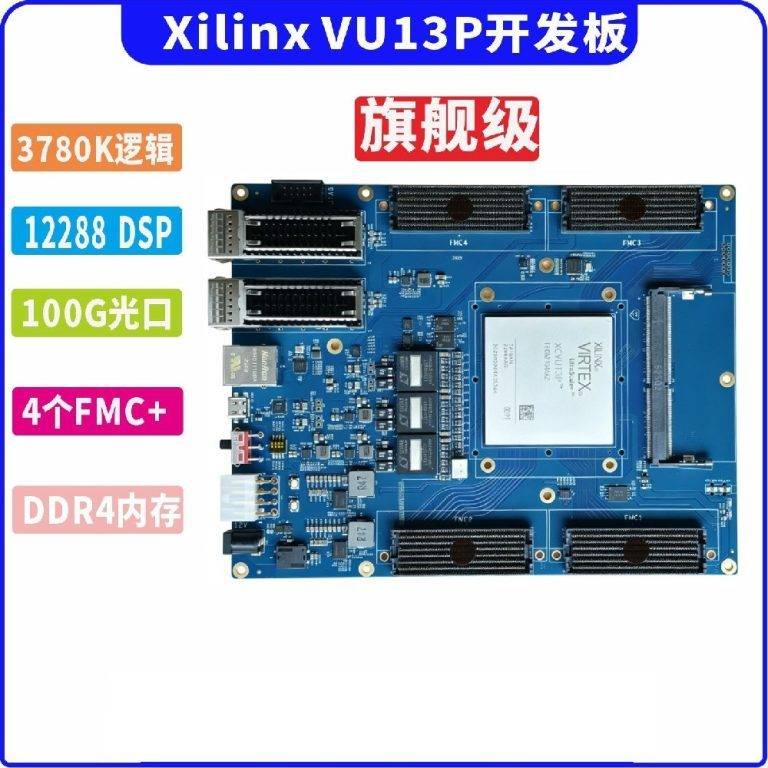
Au niveau carte, la plate-forme de développement ultra-haut de gamme VU13P de Duyuan Electronics offre des gold fingers PCIe Gen3 x16, multiples ports optiques 100G (QSFP28), expansion haute vitesse FMC+, expansion DDR4 SODIMM, et une plage de température grade industriel -40 °C à 85 °C. Pour le trading quantitatif, cette carte fournit naturellement trois choses : connecter directement multiples feeds de bourse dans le FPGA (ports optiques + GTY), placer une logique de stratégie substantielle à l’intérieur du FPGA (3,78 millions de cellules logiques + 12 288 DSP), et interconnexion hôte bidirectionnelle haute bande passante (PCIe Gen3 x16).
3. Quatre applications cœur de VU13P dans la chaîne de trading quantitatif
3.1 Décodage et prétraitement des données marché (Feed Handler)
Les protocoles de données marché de bourse (NASDAQ ITCH, CME MDP3, le format FAST couramment utilisé par les bourses européennes, etc.) arrivent à des débits de paquets extrêmement élevés ; le parsing logiciel nécessite un décodage par paquet, validation et reconstruction de structure, en faisant le goulot le plus précoce et le plus typique de la chaîne. Sur VU13P, le parsing des données marché est implémenté comme un pipeline matériel : les paquets sont décodés en flux d’octets à leur entrée dans le port optique, avec extraction de champ, validation et réassemblage de protocole complétés dans des étapes de pipeline fixes, tandis que multiples feeds (multiples bourses, lignes primaire/secours A/B) sont traités en parallèle. Les 128 transceivers GTY et multiples ports optiques 100G fournissent une capacité de connexion simultanée ample ; pour les bourses publiant via lignes duales primaire/secours (comme les lignes A/B de CME), l’arbitrage de ligne et le failover transparent peuvent être implémentés en matériel pour éviter les trous de données marché causés par la gigue de ligne simple. Les structures standard de données marché parsées sont écrites directement dans le stockage sur puce pour les modules de stratégie en aval, ne passant jamais par le CPU hôte.
3.2 Carnet d’ordres matériel et exécution parallèle de stratégie
Maintenir un carnet d’ordres requérable nécessite des opérations fréquentes d’insertion, suppression, modification et tri ; les implémentations logicielles reposent sur l’accès mémoire et les verrous, tandis que les implémentations matérielles mappent les niveaux de prix directement sur des structures Block RAM sur puce, avec lookup de prix et décisions d’appariement complétés en cycles fixes. Sur cette base, les 3,78 millions de cellules logiques de VU13P permettent à multiples instances de stratégie de tourner en parallèle sur un seul dispositif : différents instruments, différents marchés, et même différentes logiques de stratégie (market making, arbitrage cross-marché, arbitrage de latence, régression statistique) peuvent occuper des partitions logiques indépendantes, partageant le même flux de données marché parsé sans interférence. Pour les stratégies de trigger sensibles à la latence, une approche « ordre pré-armé » peut être utilisée : les modèles d’ordres sont écrits dans le buffer d’émission à l’avance, et quand le matériel détecte la condition fixée (percée de prix, changement de ratio de volume) il déclenche l’émission directement, contournant le chemin de décision logiciel, compressant la latence à des dizaines de nanosecondes.
3.3 Risque pré-trade
Les bourses et cadres de conformité imposent des exigences de risque de plus en plus strictes sur le trading algorithmique : bande de prix, plafonds de quantité par ordre, position cumulative journalière, fréquence d’ordres, et autres contrôles doivent compléter avant qu’un ordre ne soit envoyé. Le problème du contrôle de risque logiciel est qu’il se trouve sur le chemin critique et ajoute de la latence ; le contrôle de risque FPGA place la logique de contrôle en parallèle à côté du chemin d’ordres — chaque ordre passe par plusieurs étapes de contrôle de risque dans le pipeline matériel, et est immédiatement encodé et envoyé sur approbation, ou bloqué en nanosecondes sur rejet. Les règles de risque sont configurées via registres/tables mémoire et peuvent être hot-updatées pendant la journée de trading, satisfaisant les exigences de conformité sans sacrifier la basse latence sur le chemin principal.
3.4 Backtesting, simulation et accélération R&D
Au-delà de la chaîne de production, les grandes ressources logiques de VU13P supportent aussi la R&D de stratégie : charger la lecture de données marché et les moteurs de simulation sur la carte de développement pour du backtesting niveau matériel contre des données historiques, tournant multiples stratégies en parallèle — significativement plus rapide que la simulation logicielle ; utiliser Vivado/Vitis HLS pour mapper rapidement les algorithmes C/C++ en implémentations matérielles, raccourcissant le cycle d’itération « idée de stratégie → matériel testable ». Une organisation d’ingénierie typique est « FPGA tourne le chemin de production, CPU tourne la surveillance et l’analytique » : le traitement des ordres de production et des données marché se fait entièrement sur carte, tandis que l’hôte lit le statut via PCIe Gen3 x16 et pousse les paramètres de stratégie et règles de risque, équilibrant performance et opérations.
4. Architecture système typique de bout en bout
Une plate-forme de trading quantitatif basée sur VU13P a une topologie typique comme suit :
- Entrée de données marché : les feeds de bourse entrent directement dans le FPGA via ports optiques 100G (QSFP28), avec 128 paires GTY portant multiples lignes ;
- Parsing matériel : les modules Feed Handler décodent, valident et arbitrent les lignes A/B dans un pipeline selon le protocole (ITCH/FAST/MDP3, etc.) ;
- Carnet d’ordres et signaux : la BRAM sur puce maintient les carnets d’ordres pour multiples instruments, les partitions de stratégie calculent les signaux en parallèle, et les ordres sont générés quand les conditions de trigger sont remplies ;
- Risque et encodage : les ordres passent les contrôles de risque pré-trade et sont encodés en messages de protocole de bourse avant d’entrer dans le buffer d’émission ;
- Interconnexion hôte : les accusés d’ordres, rapports d’exécution et surveillance de statut sont envoyés à l’hôte via PCIe Gen3 x16 ; les paramètres de stratégie et règles de risque sont poussés depuis l’hôte ;
- Interfaces d’expansion : FMC+ est utilisé pour connecter des NIC custom / cartes filles d’accélération, OCULINK pour l’interconnexion haute vitesse board-to-board pour le scaling multi-cartes.
En forme de déploiement, la carte de développement VU13P peut servir directement de carte d’accélération PCIe à l’intérieur d’un serveur ; pour les scénarios sensibles à l’espace rack et à la puissance, un facteur de forme core board basse conso peut être customisé sur cette plate-forme.
5. Avantages d’ingénierie de VU13P par rapport aux autres approches
| Dimension | Avantage relatif VU13P (FPGA) |
|---|---|
| Latence de bout en bout | chaîne complète 300 ns–1 µs, pré-trigger 30–100 ns ; approches logicielles typiquement 1–100 µs |
| Déterminisme de latence | profondeur de pipeline fixe, pas de gigue d’interruption/ordonnancement, bon pour risque et audit |
| Capacité parallèle | 3 780K cellules logiques + 12 288 DSP, multiples stratégies/instruments simultanément |
| Bande passante d’interface | 128×GTY, multiples ports optiques 100G, PCIe Gen3 x16, feed multi-bourse direct |
| Flexibilité | reconfigurable : les changements de stratégie sont config/reload, pas de remplacement de carte ; cycle de développement beaucoup plus court que l’ASIC |
| Seuil de développement | plus bas que l’ASIC ; Vitis HLS/OpenCL mappe depuis C/C++, chemins clés davantage optimisés en RTL |
Comparé au CPU : VU13P est un ordre de grandeur devant en latence et déterministe ; comparé au GPU : les GPU excellent en débit batch mais le pipeline et l’ordonnancement introduisent une gigue de latence qui les rend inadaptés aux chemins critiques nanoseconde, tandis que la latence déterministe de VU13P est un fit naturel ; comparé à l’ASIC : l’ASIC a la meilleure performance mais coût one-time et cycle de prohibitifs, adapté seulement aux algorithmes complètement gelés, tandis que VU13P préserve la flexibilité pour l’évolution de stratégie. C’est pourquoi les sociétés de trading propriétaire adoptent largement « FPGA pour le chemin critique, CPU/GPU pour la recherche et le calcul offline » comme division de travail standard.
6. Essentiels de développement et de déploiement
- Division toolchain : chemins critiques (parsing de protocole, encodage d’ordres) utilisent RTL pour garantir la latence ; la logique de stratégie peut être rapidement implémentée avec Vitis HLS / OpenCL, validant le comportement en simulation logicielle d’abord, puis synthétisant vers le matériel ;
- Interfaces modulaires : Feed Handler, Order Book, Strategy, Risk et Gateway utilisent uniformément des interfaces de données AXI-Stream, rendant le remplacement, la réutilisation et la collaboration d’équipe plus faciles ;
- Horloge et synchronisation : dans les déploiements multi-cartes/multi-sites, introduire PTP/1PPS et un arbre d’horloge basse gigue pour unifier la base de temps, assurant l’alignement des rapports d’exécution et des timestamps de données marché ;
- Partir d’une carte standard : d’abord compléter le parsing des données marché et la validation de stratégie sur la carte de développement VU13P, faire tourner la chaîne de latence, puis customiser le facteur de forme de carte (nombre d’interfaces, puissance, structure mécanique) selon les besoins du projet ;
- Surveillance et régression : garder des compteurs de statistiques et points d’observation ILA dans la logique matérielle, surveiller la latence de pipeline par étape pendant la journée de trading, et toute dégradation peut être localisée rapidement.
7. Limites et recommandations de sélection
Le FPGA n’est pas la réponse pour chaque scénario quantitatif. Si une stratégie se rééquilibre à des horizons minute ou heure, ou repose sur des features de machine learning à grande échelle avec itérations fréquentes de modèles complexes, les avantages de coût et de flexibilité de la pile logicielle CPU/GPU sont plus évidents ; si l’équipe manque de capacité de développement matériel, le cycle d’évaluation, de débogage et de maintenance d’un projet FPGA doit être pleinement pris en compte. Quand la basse latence matérielle est confirmée comme exigence, la sélection de dispositif peut être stratifiée par besoins en ressources :
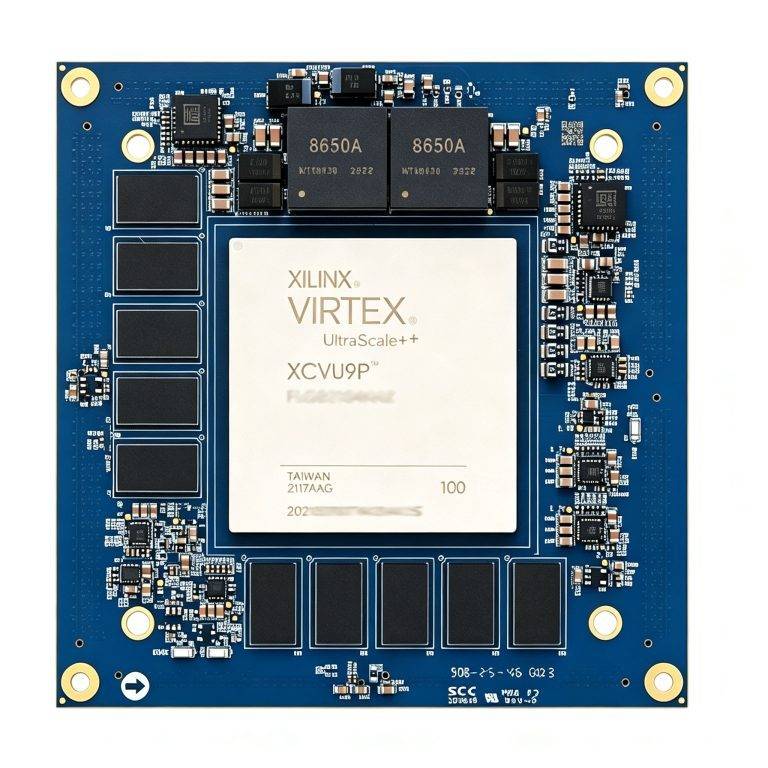
- VU9P : 2 586K cellules logiques, 6 840 DSP, avec 2×200G + 4×100G ports optiques, 32 Go DDR4 ECC, PCIe x16 — adapté aux scénarios avec grande entrée de données marché et accent sur stockage/bande passante ;
- VU13P : 3 780K cellules logiques, 12 288 DSP, 128×GTY — adapté au multi-stratégie parallèle, logique de stratégie complexe, et scénarios nécessitant plus de ressources sur puce ; la plate-forme pilier complète pour cette classe d’applications ;
- VU13F : aussi 12 288 DSP, avec 4×FMC+ fournissant une IO extensible étendue et interfaces de cartes filles — adapté à l’intégration niveau système nécessitant NIC custom, frontends RF, et autre matériel externe.
Note : les chiffres de latence dans cet article sont des plages typiques de sources publiques ; les valeurs réelles dépendent des protocoles, débits de paquets, implémentation de stratégie et routage de carte. La sélection et l’acceptation doivent être basées sur la mesure sur site.
8. Conclusion
La matérialisation du trading quantitatif est une tendance certaine depuis des années : du plus ancien offload NIC, au déplacement du parsing des données marché et de toute la chaîne d’ordres sur FPGA, à aujourd’hui où un seul dispositif classe VU13P porte simultanément données multi-marchés, multi-stratégies et contrôle de risque. La valeur de VU13P réside dans le fait de mettre « échelle » et « vitesse » sur le même dispositif — assez de logique et DSP pour que les combinaisons de stratégie complexes tournent en parallèle en matériel, et assez de GTY et ports optiques 100G pour que l’entrée multi-bourse ne soit plus un goulot. Duyuan Electronics fournit des cartes de développement standard VU13P/VU9P, core boards custom, paquets IP de décodage de données marché et de chaîne basse latence, et support technique de bout en bout, aidant les équipes à passer rapidement de la validation de carte d’évaluation à une plate-forme matérielle de trading quantitatif déployable.
Duyuan Electronics · Pratique d’application | Données en date de septembre 2026 ; différentes institutions utilisent différents périmètres, toutes sources annotées