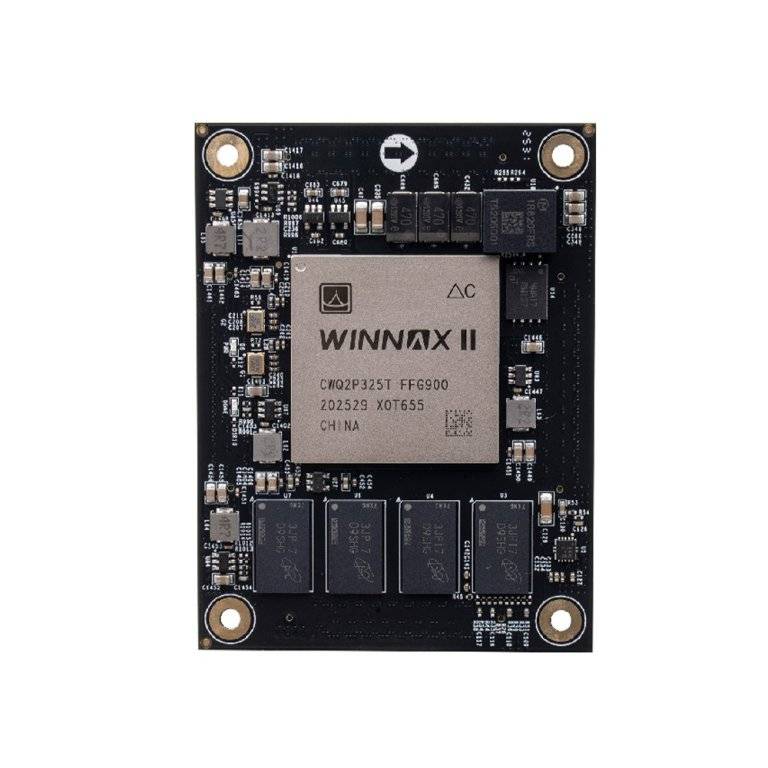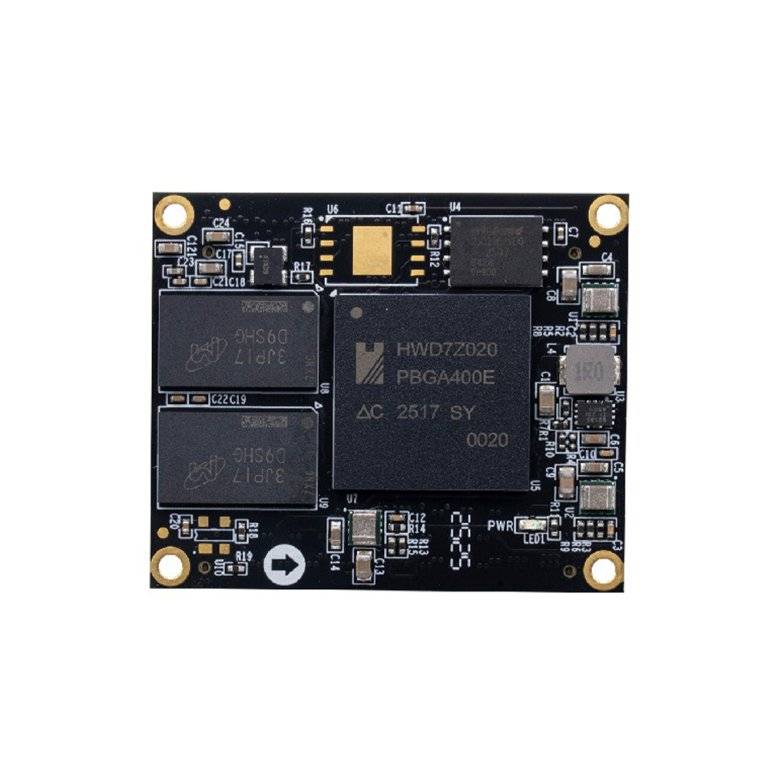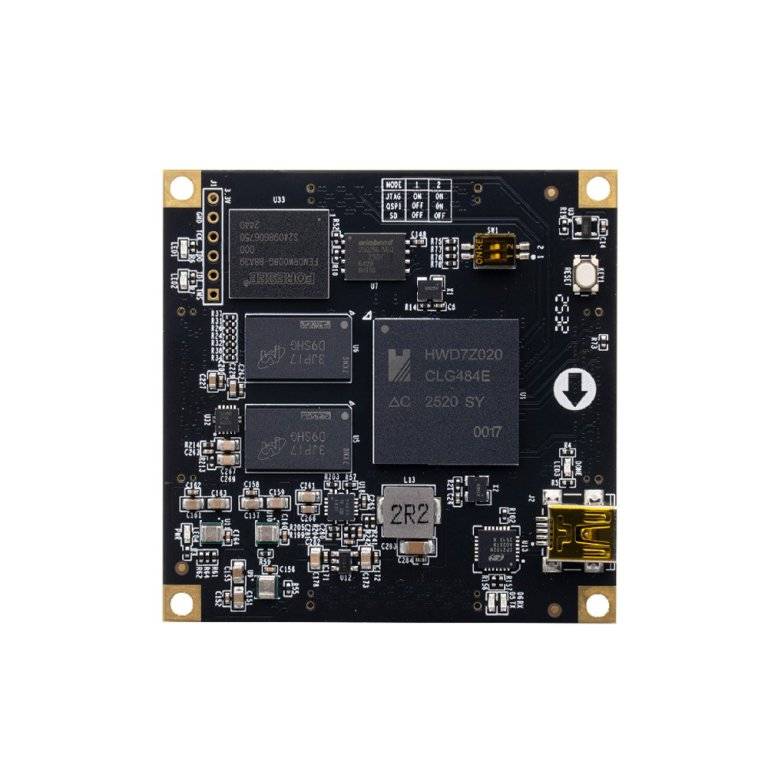
Puces FPGA chinoises : de la puce universelle à la percée indépendante — jusqu’où sommes-nous allés, que manque-t-il encore
Un marché régi pendant trois décennies par le duopole AMD (Xilinx) et Altera est désormais réécrit en Chine. Avec un marché approchant 40 milliards RMB et une autosuffisance devant franchir 30 %, les dispositifs haut de gamme au-dessus de 500K portes restent une zone interdite pour les acteurs nationaux — cet article dissèque le progrès, les fondamentaux et les eaux profondes du FPGA chinois.
FPGA (Field-Programmable Gate Array) est souvent appelé la « puce universelle » : il n’a pas de fonction fixe — après avoir été « programmé » avec un langage de description matérielle, il peut devenir un circuit dédié, et peut être redéfini en quelques millisecondes. Traitement de protocole à des taux gigabit-par-seconde dans les stations de base, beamforming dans le radar, appariement basse latence dans le trading financier, accélération déterministe dans l’inférence IA — les scénarios exigeant haut débit, basse latence et la capacité de changer à la demande sont le terrain d’entraînement du FPGA. C’est la troisième forme de calcul général largement validée après CPU et GPU, et la dernière catégorie niveau forteresse sur la liste « pénurie de puces » de la Chine à conquérir.
Contrairement à la plupart des catégories de puces, la difficulté du FPGA est double : elle nécessite de construire une puce extrêmement complexe, et d’écrire le toolchain logiciel qui rend la puce « obéissante ». En d’autres termes, les fournisseurs de FPGA ne vendent pas une puce ; ils vendent un écosystème complet de « matériel + logiciel + IP + écosystème ». C’est pourquoi le marché a été dominé par deux entreprises pendant trois décennies, et pourquoi la substitution nationale a été si difficile — et si critique — ici.
I. Trente ans de duopole : pourquoi le FPGA est si difficile
Le marché FPGA mondial a longtemps été un duopole stable : AMD (qui a achevé son acquisition d’environ 49 milliards $ de Xilinx en février 2022) et l’Altera d’Intel (acquis par Intel pour 16,7 milliards $ en 2015 ; 51 % de son equity a été vendu à Silver Lake en septembre 2025 pour opérer en tant qu’entreprise indépendante) détiennent ensemble 80 %–85 % des revenus FPGA haute densité ; Xilinx à lui seul représente environ 51 % du marché. Le marché edge basse conso est mené par Lattice, et le marché aérospatial durci radiation appartient à Microchip.
Ce paysage a une forteresse à trois couches. La première est les brevets et l’architecture : presque tous les brevets FPGA cœur sont détenus par des entreprises américaines — de la structure look-up table (LUT) et l’interconnexion programmable aux circuits de configuration — accumulés sur des décennies en une barrière serrée que les entrants ultérieurs peuvent difficilement contourner au niveau architectural. La seconde est le toolchain logiciel : Vivado de Xilinx et Quartus d’Intel sont les « systèmes d’exploitation » sur lesquels les développeurs comptent ; fermeture de temporisation, place-and-route, débogage et génération d’IP arrivent tous en plus d’eux. La troisième est les habitudes d’ingénieur et l’écosystème : les piles de protocole et algorithmes de traitement de signal d’un équipementier ont été accumulés sur Vivado pendant plus d’une décennie, avec les assets de code et l’expérience de débogage s’empilant — changer de plate-forme signifie recommencer. Ce coût de changement est plus dur à surmonter que n’importe quelle barrière de procédé sur la wafer.
C’est pourquoi la poursuite du FPGA chinois n’a jamais été aussi simple que « faire une puce » — c’est une bataille prolongée autour de l’architecture, de l’EDA et de l’écosystème.
II. Le point de bascule : sept ans après l’incident ZTE
En avril 2018, le Département du Commerce des États-Unis a émis une ordonnance de refus d’export de sept ans contre ZTE, interdisant aux entreprises américaines de lui vendre des composants, logiciels et technologies. L’incident a directement causé la perte de 6,983 milliards RMB pour ZTE cette année-là, et a fait de la « coupure d’approvisionnement FPGA » une crainte réelle dans toute l’industrie pour la première fois — à l’époque, les FPGA haut de gamme dans les stations de base communication n’avaient presque pas d’alternative nationale, et les FPGA baseband de station de base et puces serveur de Broadcom, Intel et autres étaient explicitement marqués par les courtiers comme « actuellement pas de substitut disponible ».
Depuis, avec l’incident ZTE comme déclencheur, la substitution nationale a été élevée au niveau stratégique national : le Big Fund a continuellement augmenté l’investissement, la politique Xinchuang (innovation applicative IT) s’est étendue, et l’Entity List a ajouté une pression répétée. Les clients en aval sont passés de « n’osent pas utiliser le national » à « doivent préparer le national ». Les fournisseurs chinois de FPGA ont ainsi obtenu les deux choses les plus rares — points d’entrée de commande et occasions d’essai-erreur. Dans le langage de l’industrie, la substitution avance le long d’un chemin « zones rurales encerclant les villes » : les marchés spécial et grand public bas de gamme ont complété la substitution d’abord ; le moyenne gamme communication et industriel a suivi ; les dispositifs à haute capacité au-dessus de 500K portes sont encore attaqués.
Le bond en trois étapes de la substitution
Période de percée (2018–2020) : de « inutilisable » à « osant essayer »
L’investissement Big Fund a commencé, les pilotes Xinchuang ont démarré ; les industries sensibles à la sécurité de la chaîne logistique — spécial, énergie, transport ferroviaire — ont pris la tête en adoptant les dispositifs nationaux, et le FPGA chinois est passé de zéro à un.
Montée en volume (2021–2023) : substitution à l’échelle moyenne et bas de gamme
Les procédés 40/55 nm ont mûri et les produits 28 nm sont entrés en production de masse successivement ; les marchés moyenne gamme comme la communication, le contrôle industriel et la vision machine ont monté en puissance, et les fournisseurs nationaux ont ouvert dans des scénarios comme les smart NIC serveur et les systèmes de contrôle industriel.
Attaque hard-core (2024–2026) : charger vers le haut de gamme et l’écosystème
Les produits en procédé FinFET ont atterri, les dispositifs porte milliard ont été lancés, le SoPC hétérogène a progressé vers l’usage commercial ; le champ de bataille principal a shifté vers l’attaque frontale sur les dispositifs à haute capacité, les procédés avancés et l’écosystème logiciel.
III. Où nous en sommes aujourd’hui : marché, part et autosuffisance
D’abord, les totaux. Selon une prévision de China Research Intelligence, le marché chinois de puces FPGA était d’environ 24,99 milliards RMB en 2024, en hausse de 19,78 % en glissement annuel, devant dépasser 33,22 milliards RMB en 2025, avec un taux de croissance annuel composé d’environ 22,5 % de 2025 à 2030. Les chiffres de Frost & Sullivan diffèrent légèrement : le marché chinois FPGA est passé d’environ 15,03 milliards RMB en 2020 à environ 33,22 milliards RMB en 2025, une croissance composée d’environ 17,2 % ; il prévoit aussi que le marché FPGA mondial dépassera 12,5 milliards $ en 2025. Markets and Markets s’attend à ce que le marché mondial atteigne environ 19,34 milliards $ d’ici 2030, avec un CAGR 2025–2030 de 10,5 %, et l’Asie-Pacifique comme région à la croissance la plus rapide mondialement.
Puis les résultats. Au cours des sept ans de substitution nationale, le changement le plus intuitif est dans la part : la part combinée des deux géants internationaux en Chine est tombée d’environ 78 % en 2021 à environ 57 % en 2025, tandis que Ziguang Tongchuang, Fudan Microelectronics et Anlogic ensemble approchaient 29 %. Morgan Stanley s’attend à ce que le taux d’autosuffisance FPGA de la Chine monte à environ 37 % d’ici 2025, avec le TAM global des fournisseurs locaux passant de 476 millions $ en 2021 à environ 2 milliards $, une croissance composée d’environ 42 % sur la période.
Mais en décomposant, la qualité de la substitution est inégale : les marchés spécial et grand public bas de gamme ont fondamentalement atteint l’autonomie ; le moyenne gamme communication et industriel accélère la pénétration ; les dispositifs à haute capacité au-dessus de 500K portes restent « une zone interdite pour les vendeurs internationaux » — les produits flagship nationaux se concentrent sous 500K éléments logiques, avec des procédés non avancés tenant la part principale. Au-delà de la croissance d’échelle, les batailles dures structurelles commencent à peine.
IV. Le paysage des fournisseurs : cinq forces avançant en parallèle
Le FPGA chinois n’est pas un show à un joueur, mais un paysage multipolaire avec Ziguang Tongchuang comme leader, Fudan Microelectronics et Anlogic comme deux ailes, et Gowin et Jingwei Qili spécialisés dans les pistes de niche, plus Chengdu SinoMicro, Zhongke Yihaiwei et autres comme forces spéciales.
| Fabricant | Produits représentatifs & technologie | Nœud de procédé | Marchés primaires |
|---|---|---|---|
| Ziguang Tongchuang (PANGOMICRO) | Logos-2 (25K–200K LUT) ; Titan-3 (FinFET, ciblant le haut de gamme international) ; PG3T1300/1500 porte milliard ; Kosmo-2/3 (hétérogène CPU+FPGA+NPU) | 28 nm / FinFET | Communication, cybersécurité, data center, inférence IA, industriel, automobile |
| Fudan Microelectronics | Porte milliard 28 nm (premier produit en série en Chine, ~700K éléments logiques, SerDes 13,1 Gbps, DDR4, cœur ARM dur + accélération IA) ; quatre séries : 10M/100M/porte milliard/SoPC | 28 nm en production de masse, 14 nm essai | Réseaux cœur communication, dispositifs médicaux, automobile, spécial |
| Anlogic | Série 28 nm PH1A, FPSoC (SoC FPGA) ; ELF5 basse conso petite capacité (2,5K–15K LUT, 55 nm) | 28 nm / 55 nm | Contrôle industriel, drivers d’affichage, périphériques serveur IA, électronique grand public |
| Gowin | Gowin LittleBee GW1N (55 nm), série basse conso ChenXi GW2A | 55 nm / 28 nm | Edge basse conso, industriel, grand public |
| Jingwei Qili | Plate-forme de calcul reconfigurable CPE (processeur + fusion de logique programmable) | Niveau 28 nm | Industriel, intelligence edge, Xinchuang chinois |
Deux signaux méritent d’être notés. D’abord, Ziguang Tongchuang a lancé la série Titan-3 basée FinFET en 2024 ; les PG3T1300 et PG3T1500 sont appelés par l’entreprise « les deux seuls produits FPGA haut de gamme porte milliard en Chine avec IP indépendante » et sont entrés dans des scénarios communication haut de gamme et data center ; en 2025 il a complété le dépôt de tutorat IPO, une étape landmark pour le FPGA chinois vers le marché des capitaux. Deuxièmement, Fudan Microelectronics, un vétéran qui a démarré la R&D FPGA en 2004, a été le premier à atteindre la production de masse d’une puce porte milliard 28 nm — « première chinoise » — et s’est étendu vers le bas en production d’essai 10 milliards de portes et la ligne de produits PSoC. Anlogic, quant à lui, suit une route « entièrement auto-développée + double piste haut et bas de gamme » : moyenne gamme 28 nm + petite capacité basse conso 55 nm, avec la série ELF5 lancée en 2026 ciblant les périphériques serveur IA et l’automatisation industrielle.
V. Progrès technologique : de 55 nm à FinFET, de millions de portes à milliards
En regardant la coupe transversale du procédé et de l’échelle, le FPGA chinois achève un bond générationnel : les dispositifs 40/55 nm ont longtemps été matures en production de masse, 28 nm est devenu le nœud mainstream actuel, les produits en procédé FinFET ont atterri en 2024, et les produits niveau 14 nm entrent en production d’essai. En échelle logique, les dispositifs nationaux ont franchi de millions de portes à des dizaines de millions et ont pris pied ; le niveau porte milliard (environ 700K–1M éléments logiques) a atteint la percée « zéro à un ».
Nœuds matures (55/40 nm) · produits en série
Les dispositifs basse conso petite capacité (Gowin LittleBee, Anlogic ELF, etc.) couvrent le contrôle industriel et l’électronique grand public ; les acteurs nationaux ont déjà une compétitivité complète dans cette plage.
Nœud mainstream actuel (28 nm) · pleinement déployé
Ziguang Tongchuang Logos-2/Titan-2, le porte milliard de Fudan, et Anlogic PH1A sont tous basés sur 28 nm ; les interfaces haute vitesse comme SerDes (10–13,1 Gbps), DDR3/DDR4 et PCIe Gen3 sont progressivement complètes.
Nœud avancé (14 nm / FinFET) · brisant la glace
Ziguang Tongchuang Titan-3 (FinFET, 2024) cible le haut de gamme international ; le 10 milliards de portes 14 nm de Fudan entre en production d’essai, avec la capacité haut de gamme et les métriques de puissance convergeant vers les produits internationaux.
Bond architectural (intégration hétérogène) · avançant en parallèle
Le SoPC/PSoC national progresse de « FPGA + CPU dur » vers le multi-cœur hétérogène « CPU + FPGA + NPU » (Ziguang Kosmo, Fudan PSoC), avec la route vers Xilinx Zynq/Versal commençant à prendre forme.
Mais nous devons rester sobres : le procédé n’est que le ticket d’entrée ; l’architecture et le logiciel sont la vraie ligne de démarcation. Les produits haut de gamme des géants internationaux (AMD Versal ACAP, Intel Agilex 7) ont upgradé le FPGA en « plates-formes de calcul adaptatif », intégrant des tableaux de processeurs vectoriels AI Engine, architectures dédiées multi-domaines et IP réseau niveau data center — la série Versal AI Core revendique un ratio performance-par-watt de 2,7× sur les concurrents 10 nm. Le benchmarking complet de telle capacité niveau plate-forme est encore en poursuite précoce pour les acteurs nationaux.
VI. La vraie eau profonde : cinq défis majeurs
Défi 1 : l’EDA et le toolchain logiciel — la muraille la plus dure
Le professeur Wei Shaojun, directeur de l’Institut de Microélectronique à l’Université Tsinghua, a dit sans détour qu’au niveau national, sur la « synthèse logique » et le « place-and-route » — les deux cœurs de l’EDA — « il n’y a fondamentalement aucune contribution, et elles ne sont même pas touchées ». Cette remarque reste la note de bas de page la plus douloureuse du FPGA chinois. Quand Chengdu SinoMicro a sorti son premier outil EDA durci en synthèse logique porte milliard en 2026, son dirigeant a de même souligné que pour les FPGA à grande échelle, « la percée de performance matérielle est une chose, mais le goulot de performance plus critique réside dans le logiciel ».
Le gap est tangible dans l’expérience de développement : sur des designs ciblant 200 MHz+, les outils nationaux PDS/TD nécessitent souvent 3–4 tours d’itération place-and-route, même du floorplanning manuel, pour converger, tandis que Vivado peut passer en un tour ; la profondeur du catalogue IP est aussi visiblement superficielle — les toolchains nationaux couvrent environ 40 cœurs comme DDR3/DDR4, PCIe Gen2/3, SGMII et interfaces vidéo basiques, tandis que les IP ADC/DAC haute vitesse comme JESD204B/C couramment utilisés restent vierges. Chaque itération du toolchain détermine directement l’utilisabilité du FPGA chinois dans les designs haut de gamme.
Défi 2 : écosystème et habitudes d’ingénieur — une forteresse plus dure à franchir que le procédé
Comme discuté ci-dessus, les assets de code, scripts de debug et mémoire musculaire d’ingénieur accumulés sur Vivado/Quartus pendant plus d’une décennie constituent la stickiness utilisateur la plus forte. Changer de plate-forme FPGA pour un équipementier signifie réécrire les piles de protocole, re-chronométrer, racheter l’IP — un coût extrêmement élevé. Pour briser cette « barrière d’habitude », les fournisseurs nationaux ne peuvent compter sur la seule performance-prix des dispositifs ; ils ont besoin d’outils de migration, IP compatible et support technique proche — un projet d’écosystème à long terme.
Défi 3 : procédé et capacité des dispositifs haut de gamme
Les produits flagship nationaux se concentrent encore aux nœuds matures de 28 nm et en dessous ; les procédés avancés 7 nm et en dessous, les ressources logiques ultra-larges et le FPGA IA niveau data center sont en retard sur les leaders internationaux ; les exigences de dispositif haut de gamme comme SerDes ultra-haute vitesse (56G/112G PAM4), intégration HBM et emballe avancé (2.5D/3D) sont encore en construction. Contraints par l’équipement externe et la capacité, l’accès aux procédés avancés est aussi moins fluide que pour les fournisseurs internationaux.
Défi 4 : fermer la boucle commerciale — de « capable de fabriquer » à « capable de bien vendre »
Le PDG de Jingwei Qili, Wang Haili, a résumé six barrières auxquelles le FPGA chinois fait face pour atteindre le marché : prix de puce, migration système, efficacité logicielle, stabilité produit, maintenance après-vente et expédition en volume. Le FPGA a un seuil d’usage élevé et des cycles de vérification longs ; les clients ne baisseront pas leurs exigences de stabilité et d’approvisionnement long juste à cause du label « made in China ». Et l’échelle de revenus des fournisseurs nationaux reste petite, avec l’investissement R&D et les pressions de montée en capacité coexistants.
Défi 5 : gap de talents
Le FPGA est la catégorie de puce qui requiert le plus de capacités interdisciplinaires — architecture de dispositif, algorithmes EDA et développement d’application sont tous indispensables. Au niveau national, les talents seniors en algorithmes EDA place-and-route sont « presque inexistants », et les ingénieurs seniors avec à la fois de l’expérience FPGA et du design niveau système ont longtemps été en pénurie ; les réserves de talents contraignent directement le sprint vers le haut de gamme.
VII. Directions de percée : quatre chemins visibles
Les défis sont nombreux, mais les chemins de percée sont déjà clairs — et validés par l’industrie :
Premièrement, upgrader vers des « solutions système » au lieu de vendre la puce seule. Les avantages performance-prix et de réponse de service du FPGA chinois en moyenne et bas de gamme sont évidents, mais la valeur monocouche est limitée. Former une chaîne complète « puce–carte–système » avec les vendeurs de carte, fournisseurs de solution et intégrateurs système (comme on le voit couramment dans le modèle de bundling « FPGA + carte » dans les stations de base et NIC serveur) pour épaissir la valeur est un chemin réaliste pour augmenter les expéditions de dispositifs nationaux.
Deuxièmement, jalonner le calcul déterministe à l’ère de l’IA. L’inférence IA et les cartes d’accélération ont rallumé la valeur du FPGA : basse latence, reconfigurabilité et puissance contrôlable — particulièrement adapté au SmartNIC, à l’inférence edge et au trading haute fréquence. Le FPGA IA niveau data center est le nouveau champ de bataille des géants internationaux, et aussi une fenêtre d’opportunité pour les fournisseurs nationaux de contourner la compétition GPU directe et entrer via « compute offload + network processing ».
Troisièmement, l’attaque EDA shift de « suivre » à « lier aux dispositifs ». La sortie pour l’EDA nationale n’est pas de répliquer Vivado, mais de se lier profondément avec les dispositifs nationaux, d’aller en profondeur et en précision dans des domaines spécifiques (spécial, industriel, vidéo), de construire la réputation avec « assez bon, stable, service proche », puis de s’étendre progressivement vers le haut de gamme généraliste.
Quatrièmement, la capitalisation et la consolidation accélèrent la concentration industrielle. Ziguang Tongchuang sprinte vers l’IPO, Anlogic est déjà coté, et beaucoup de fournisseurs ont reçu le soutien du Big Fund et du capital industriel — le financement par cotation supportera la R&D de procédé avancé et l’investissement écosystème, et la consolidation industrielle évitera les ressources dispersées et formera de vraies forces de tête.
Conclusion : de la « substitution » à la « définition »
En sept ans, le FPGA chinois a complété le bond de « pas de puce disponible » à « osant utiliser les puces nationales » : autosuffisance approchant 40 %, dispositifs porte milliard en production de masse, procédé FinFest atterri, et cinq fournisseurs debout dans leurs pistes. Mais l’eau profonde est tout aussi réelle — les toolchains EDA, dispositifs haut de gamme et écosystème de développeurs tardent encore sur les géants internationaux, et la boucle commerciale vient de commencer.
La nature spéciale du FPGA est qu’il teste non pas une percée pointue, mais la capacité systémique de « puce + logiciel + écosystème + scénarios ». Heureusement, la Chine a le plus grand marché d’application aval au monde, l’écosystème de cartes et systèmes le plus complet, et vague après vague de demande de substitution forcée par l’être « étranglé ». De la « substitution » à la « définition », le chemin est long, mais la direction est déjà irréversible.
Duyuan Electronics · Perspectives sectorielles | Données en date de septembre 2026 ; les chiffres de différentes institutions diffèrent, chacun a été annoté avec sa source