Retours d’expérience et conseils de sélection de l’équipe R&D de Duyuan Electronics : conception d’interfaces haut débit, traitement du signal radar et communications, plates-formes de calcul hétérogène et substitution nationale, pour vous éviter des détours dans le choix des composants et la mise en œuvre des solutions.
La substitution nationale n'est pas aussi simple que « remplacer une puce ». Beaucoup d'équipes ne comparent que le prix unitaire et les ressources logiques lors du choix, pour découvrir en migrant que toolchain, IP cores, routage PCB et courbe d'apprentissage des ingénieurs doivent tous être recalculés. Cet article donne un cadre TCO qui détaille chaque coût de migration, pour décider si cela vaut le coup.
La facture de bande passante PCIe est bien plus complexe que le chiffre sur la fiche technique — débit brut, surcharge de codage, surcharge protocolaire, efficacité DMA et goulot DDR grignotent chacun ce « 16 Go/s ». Cet article déroule Gen3 x4/x8/x16, jusqu'au matching DDR et DMA, et donne une méthode réutilisable pour estimer la bande passante nette.
Sur une ligne d'inspection de défauts, du pixel caméra au signal de rejet, où le FPGA est-il irremplaçable ? Cet article calcule d'abord le budget de bande passante du flux complet, puis détaille les quatre rôles du FPGA dans la chaîne visuelle, compare les limites temps réel des algorithmes classiques vs deep learning, et termine par un choix matériel déployable sur un cas réel d'AOI à joints brasés sur PCB.
Oscilloscopes, digitizers, radars à réseau phasé, radios logicielles et surveillance des vibrations haute vitesse — le cœur de tous ces systèmes est « échantillonnage ADC haute vitesse → empaquetage de données → transfert vers l'hôte pour traitement ». Pourquoi cette étape doit-elle utiliser un FPGA plutôt qu'un MCU, un DSP ou un CPU échantillonnant directement ? Pourquoi le connecteur FMC HPC et l'interface PCIe x8 sont-ils devenus la combinaison dorée pour les cartes d'acquisition haute vitesse ? Cet article part d'un projet réel d'acquisition 250 MSPS.
L'une des questions les plus fréquentes que Duyuan Electronics reçoit ces deux dernières années est : « Nous utilisions Xilinx XC7K325T, et maintenant nous avons besoin d'un remplacement chinois. Le Fudan Micro JFM7K325T peut-il être un drop-in direct ? Combien de code devons-nous changer ? Devons-nous redessiner le PCB ? Combien de performance perdons-nous ? » Cet article met trois paires de modèles mainstream de la série Fudan Micro JFM7 et du côté AMD/Xilinx série 7 côte à côte, et explique exactement jusqu'où un « drop-in replacement » tient vraiment.
Nous sommes en 2026. Le plus récent Versal AI Edge d'AMD est en vente depuis des années, et UltraScale+ est déjà un nœud de procédé d'il y a une décennie. Pourtant une part significative des demandes que Duyuan Electronics reçoit chaque semaine spécifie encore explicitement Kintex-7 (XC7K325T, XC7K410T, XC7K160T). Non pas parce que ces clients ne peuvent pas payer UltraScale+, mais parce que dans de nombreux produits réels Kintex-7 est en fait le choix plus rationnel. Cet article déroule quatre scénarios typiques.
Au cours des trois dernières années, la « substitution nationale » dans l'industrie FPGA est passée d'un slogan à de vraies commandes. Cet article donne une comparaison horizontale 2026 des FPGA chinois moyenne gamme de Pango, FMSH et Anlogic.
L'essence du trading quantitatif est de compléter la boucle d'information « arrivée des données marché → calcul de signal → transmission des ordres » dans le temps le plus court possible. Cet article utilise la plate-forme AMD Virtex UltraScale+ XCVU13P (VU13P) comme fil conducteur, expliquant pourquoi elle convient au trading quantitatif et comment la déployer en une chaîne de trading basse latence livrable.
Un marché régi pendant trois décennies par le duopole AMD (Xilinx) et Altera est désormais réécrit en Chine. Avec un marché approchant 40 milliards RMB et une autosuffisance devant franchir 30 %, les dispositifs haut de gamme au-dessus de 500K portes restent une zone interdite pour les acteurs nationaux — cet article dissèque le progrès, les fondamentaux et les eaux profondes du FPGA chinois.
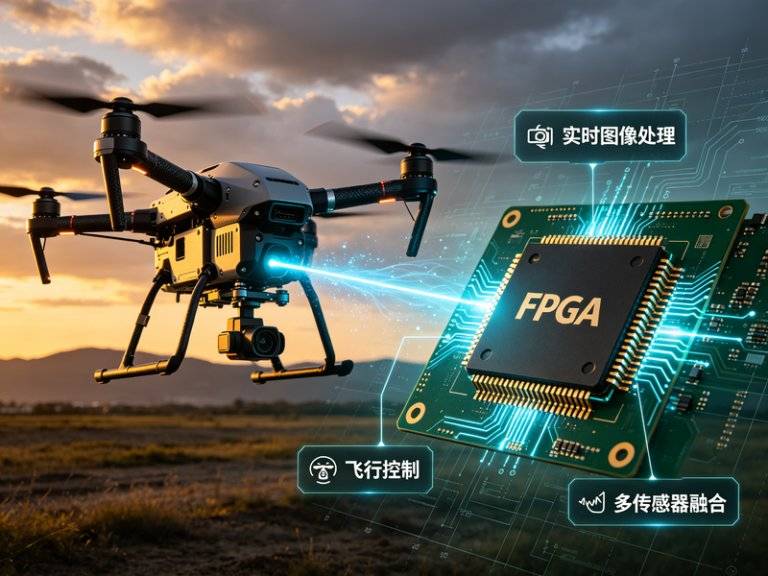
Dans le design des architectures de calcul embarquées pour drones haut de gamme, « FPGA pur ou MPSoC » est une question cœur inévitable. Le FPGA pur excelle en parallélisme matériel et latence déterministe ; le MPSoC intègre CPU, cœurs temps réel et logique programmable sur une seule puce, équilibrant flexibilité logicielle et accélération matérielle. Les deux ne sont pas de simples substituts — ils correspondent à des caractéristiques de charge de travail fondamentalement différentes.
Contactez l’équipe R&D pour des documents techniques et des conseils de sélection adaptés à votre projet.
Contact · +86 18621324348